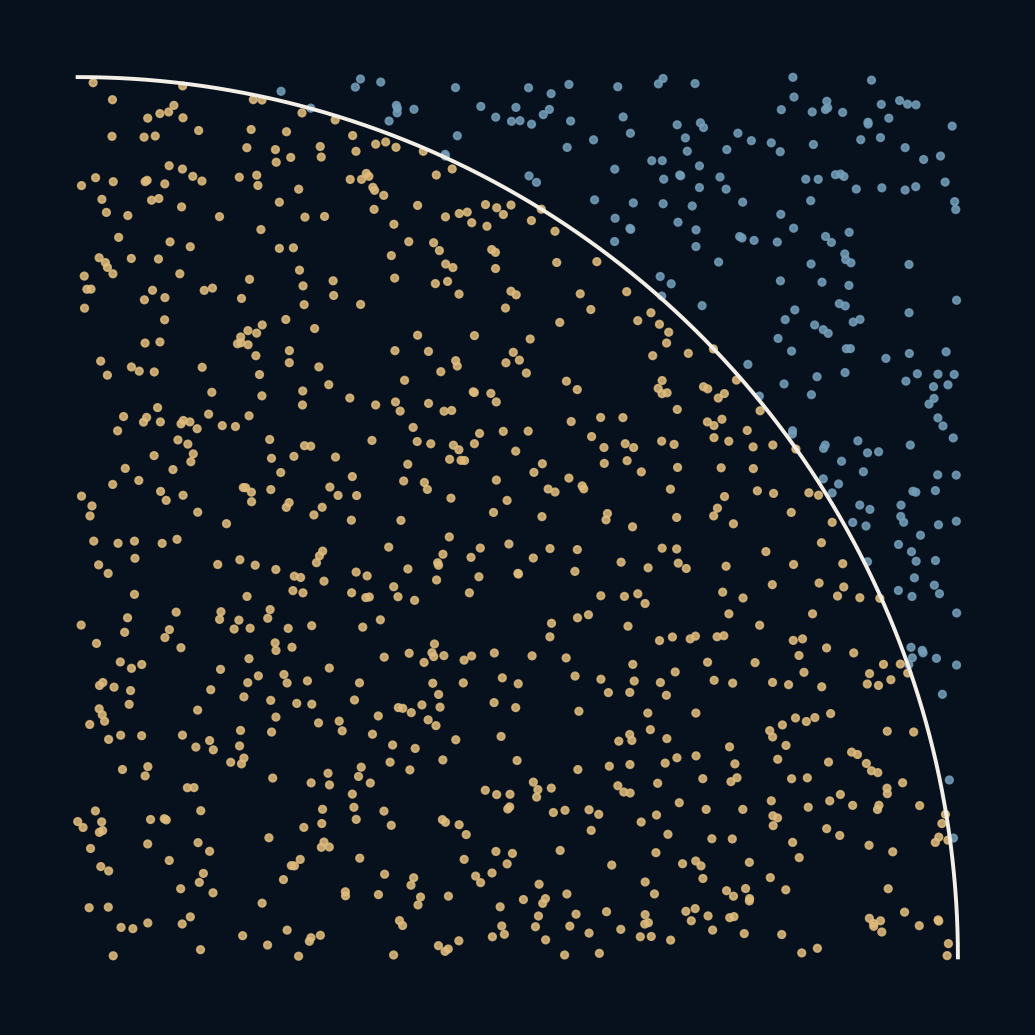
圆周率没有变,变的是我们的估计。
计算圆周率,有很多比往图里撒点更好的方法。但它恰好很适合解释蒙特卡洛估计:答案已知,所以不确定性看得见。我们能观察随机过程如何靠近一个固定数量,而不必假装每增加一个点都必然更准。值得学的不是收集更多小数位的新办法,而是随机样本怎样用于测量,以及额外的确定性为什么会这么昂贵。
样本更多,会缩小不确定性,但不会把单次运行里的运气彻底消除。
圆把一个概率藏进了正方形
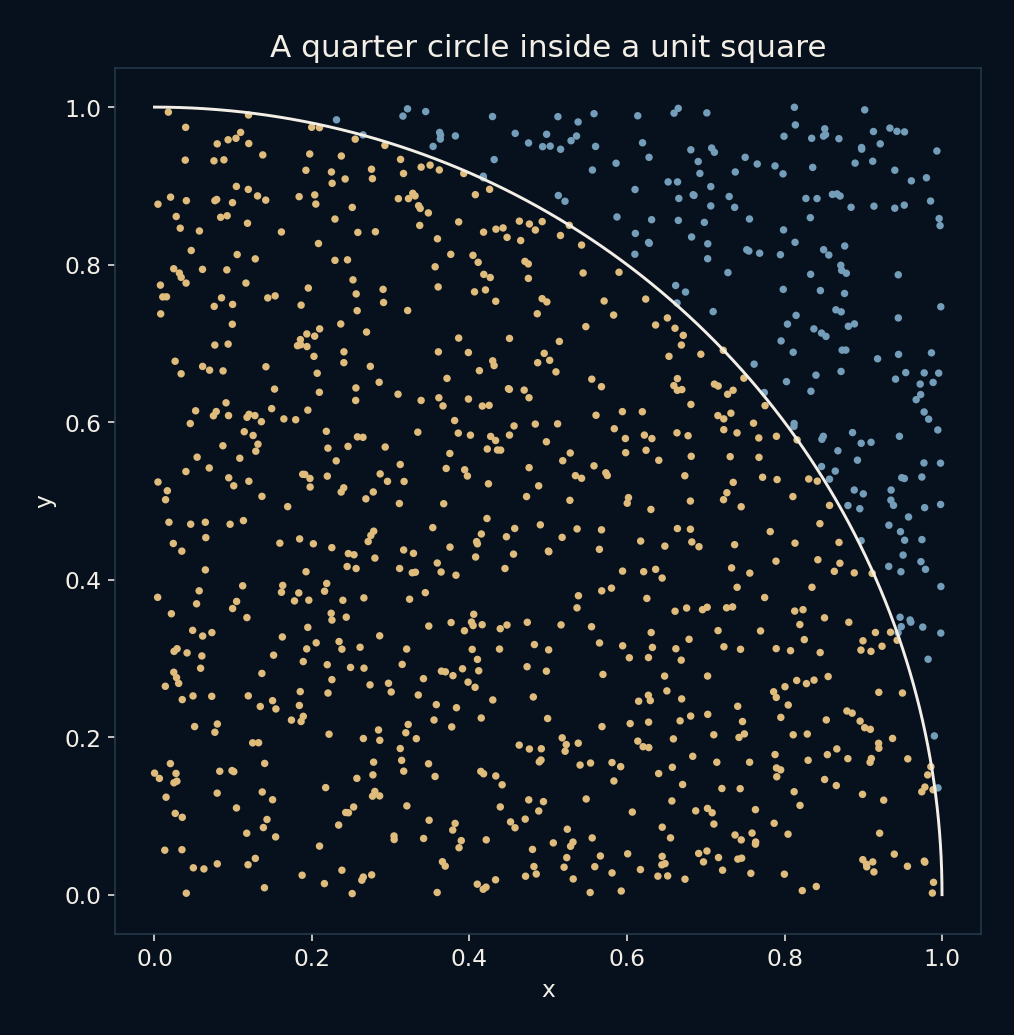
取两个坐标都从零到一的正方形,里面正好容纳半径为一的四分之一圆。正方形面积是一,四分之一圆面积是圆周率除以四。如果点在整个正方形里均匀分布,落入圆内的概率就是圆周率除以四。把实际落入的比例乘以四,就得到圆周率的估计值。
判断一个点是否在内,只需要检查 x 的平方加 y 的平方是否不超过一。面积计算就这样变成一串是与否的计数。假设也随之清楚:撒点不均匀会估计另一个概率;样本之间若有关联,不确定性的计算也会改变。
大方向正确,过程仍然可以来回晃
点很少时,把一个点从圆外移到圆内,比例就会显著变化。点很多时,一个点的影响会变小,所以长一些的运行看起来更平稳。但这不意味着误差每一步都减小。短运行可能碰巧非常准,后面的结果反而离答案远了一点。如果只展示曲线顺滑的那一段,就会隐藏这种正常表现。
固定随机种子让演示可以复现,但不会让其他运行必然得到同样结果,也不是随机数生成器的质量认证。这里使用种子,是为了重新运行时,配图与数值能保持一致。
一组分布,比挑一次喜欢的结果诚实
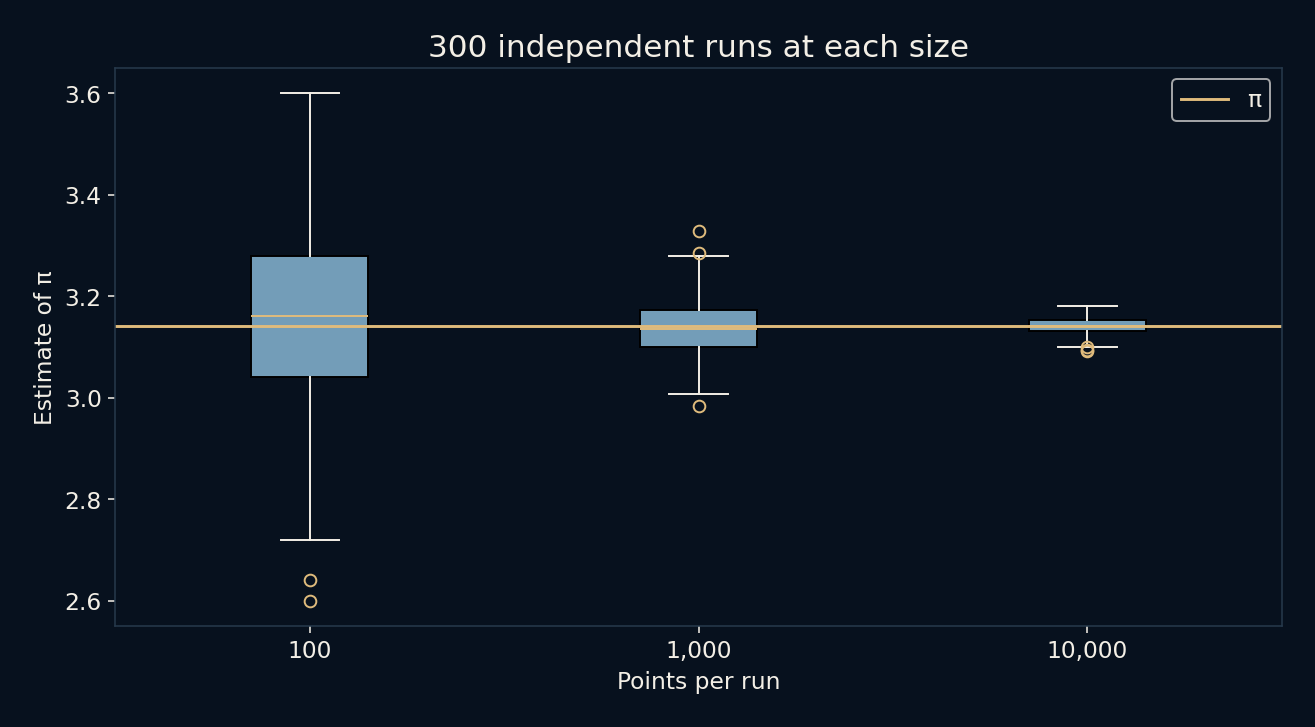
在 100、1,000、10,000 三种样本量下,各重复估计 300 次。估计均值分别约为 3.1477、3.1378、3.1413。只报告这些均值,会让方法看起来比单次运行更稳定,因为每个均值都合并了许多次独立尝试。
因此,还计算每次估计相对圆周率的误差,再对 300 次误差计算均方根。得到的 RMS 误差约为 0.1608、0.0530、0.0158。这些是本次固定种子重复实验的观察摘要,描述的是一组尝试的分布,不是下一次估计的保证。
工作量约翻四倍,典型误差才约减半
在独立均匀采样假设下,圆内点数符合二项分布模型。估计值的标准差按样本量平方根的倒数下降。因此,点数翻倍通常不会让不确定性减半。想实现大约减半,需要约四倍样本;想减少十倍,需要约一百倍样本。
观察到的三个 RMS 数值大致符合这一规律,也带有有限次运行的波动。平方根关系描述的是模型下的采样分布,不保证每条展示曲线都平滑下降。它也提醒我们:有时应该寻找更好的估计方法,而不是不停给低效方法追加计算量。
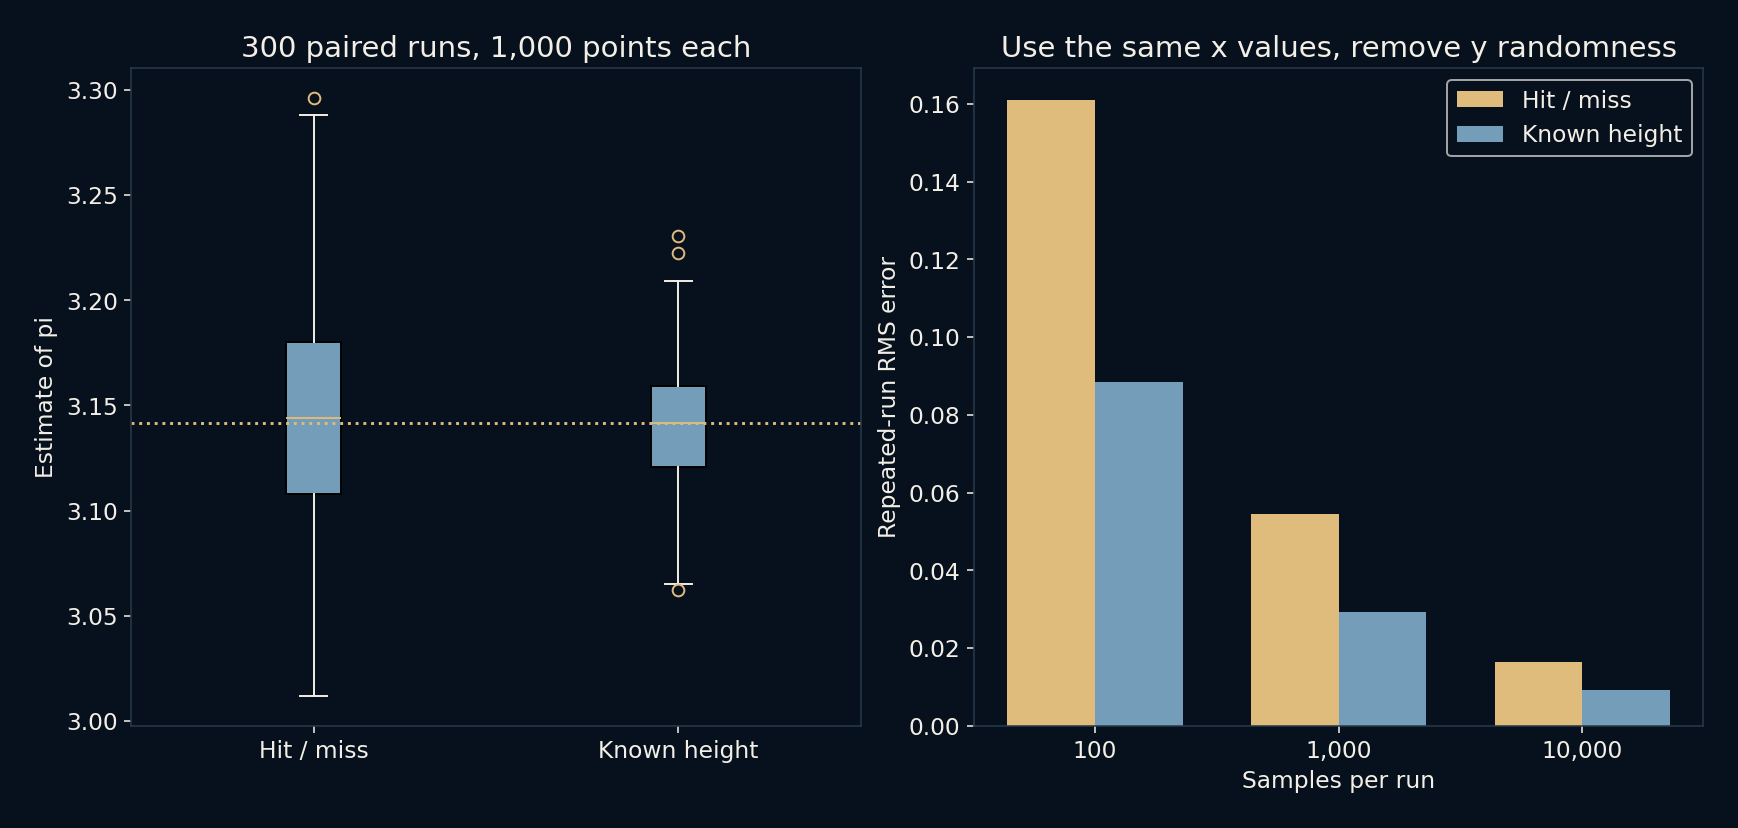
这个改善也有解析解释。n个独立样本下,命中计数法方差为(4π − π²)/n,约2.69677/n;高度法为(32/3 − π²)/n,约0.79706/n。因此,同样n下,后者标准差约是前者的0.5437倍。脚本另外以数值积分检查高度的一阶与二阶积分。这不保证每对结果里高度法都更接近,也没有测运行时间。它用已知边界公式换取较少随机性,别的积分未必有这个条件。
真正有价值的地方,在更难的形状里
对于圆周率,直接数值方法高效得多。蒙特卡洛方法更适合那些难以直接求值、却比较容易生成随机例子的数量,例如复杂空间里的积分或模拟结果。基本结构相似:定义数量,按明确分布抽样,再给出摘要与不确定性估计。
分布和样本量同样重要。从错误模型抽一百万次样,也可能只是很精确地回答了错误问题。真实模拟还需要检查假设、数值实现和样本之间的依赖。正方形与圆的图避开了大部分复杂因素,让统计思想可以清楚呈现。
增加样本前,先用上已知信息
在单位正方形内固定x后,四分之一圆的高度就是1减x平方再开方。均匀y落在该高度以下的概率,恰好等于这个高度。与其再抽y、记录带噪声的0或1,不如直接平均已知高度,再乘四。两种估计都以圆周率为目标,但后者已经把竖直方向的随机性平均掉了。这是利用条件信息降低方差的具体例子。
新比较使用种子1930,每个原样本规模做300对运行,同一对共享x坐标。1,000个样本时,命中计数法RMS为0.05439,高度法为0.02928;100个样本时分别0.16114、0.08845;10,000个样本时分别0.01643、0.00916。这与前面的种子930是独立实验。配对设计让比较更清楚,而不是从任一方法里挑一次特别幸运的结果。
看波动范围,不只看漂亮的小数
模拟输出很多小数位时,很容易把显示格式当成掌握了多少知识。3.141309 的确是计算结果,但每一位数字并没有同样的确定性。重复运行的波动,比程序选择打印多少个字符更能说明这个过程的表现。
本地检查用已知点验证边界判断,确认估计值都落在零到四之间,并核对这三种样本量下观察到的 RMS 顺序。它们没有证明普遍的单调改善。圆给了我们一个已知答案,方便练习如何怀疑模拟结果,以后面对未知答案时才不至于只看输出好不好看。