忙碌率95%的服务,可能让人等待远超一次服务所需的时间。
设想一个只有一名工作人员的虚构柜台。每件任务平均耗时一个单位,但实际时长不同,到达间隔也不同。没有设备故障,长期到达速度也低于平均处理能力,队列却仍会变长。能处理平均工作量,不等于能立刻吸收每一阵高峰。
空余能力,让队列有时间恢复。
到达和处理都有波动
实验让到达间隔与服务时长分别服从独立的指数分布,平均服务时间为一个任意单位。利用率是到达率除以服务率;在平稳模型中,0.5表示服务台有一半时间忙碌。任务按到达顺序处理,没有人中途离开。
新任务遇到未完成工作时,必须等待剩余服务和前面所有任务。积压尚未清空,下一个任务可能又来了。安静时段消化队列,突发到达建立队列。波动是本例的核心;若把间隔和时长都换成等距常数,就变成另一个系统。
最后几个百分点很昂贵
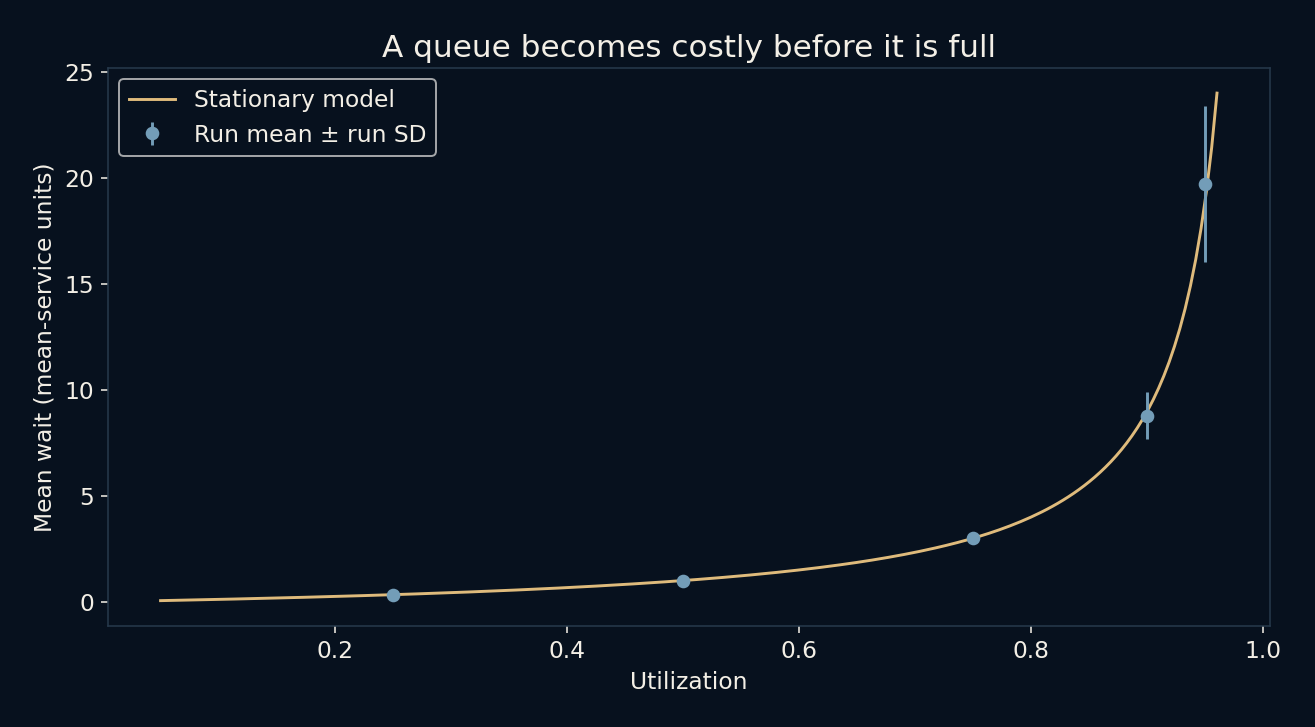
这个理想平稳模型的平均等待时间等于利用率除以一减利用率,以平均服务时间为单位。50%利用率时为1,75%时为3,90%时为9,95%时为19。这还不含服务本身,计算总停留时间需要再加平均服务时长。
本地模拟在这四档测得0.996、3.001、8.775和19.728,跟随曲线但并非完全相等。90%提高到95%,表面忙碌程度只增一点,理论等待却超过翻倍。剩余的一小块恢复空间,实际承担了很大作用。
平均值掩盖了体验的不均匀
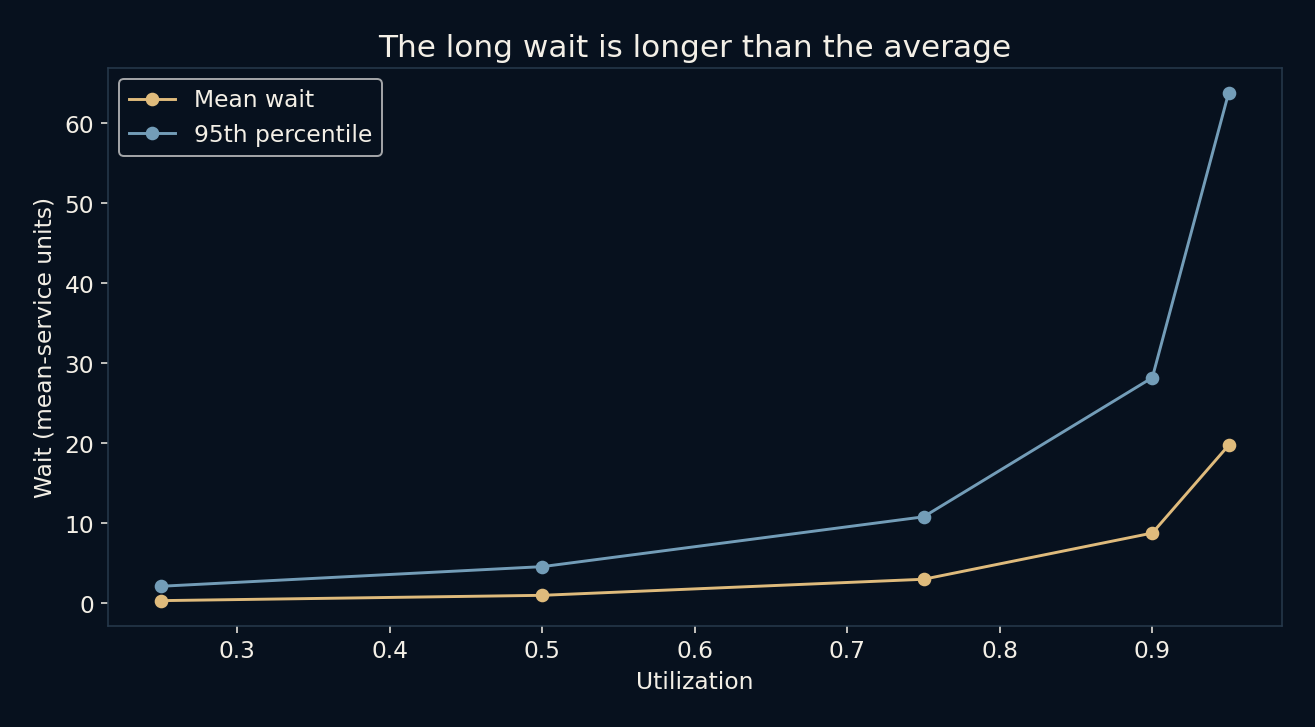
平均等十九个单位,不代表每件任务都等十九个单位。有些恰逢空台,等待为零;另一些遇到持续拥堵。95%利用率时,模拟等待的95百分位约63.734,合并保留样本中约二十分之一的等待超过它。
50%利用率时,平均等待约1,95百分位却约4.579。百分位展示平均值以外的体验,但仍是有限数据的估计。罕见的长拥堵会影响均值和尾部,高负荷下尤其明显。
从空队列开始,会占一点便宜
每次模拟都从空台开始,立刻统计会享有长期运行系统未必具备的暂时优势。因此,每次先舍弃10,000次到达,再记录50,000次等待。每档做12次独立运行,让单条漂亮曲线容易掩盖的波动显现。
舍弃热身期不证明剩余样本完全平稳。95%利用率下,12次平均值的标准差约3.678,远大于轻负载。队列内相邻等待共享积压,因此并不独立;把每次等待当独立证据,会夸大这次运行的信息量。
这是提醒,不是排班计算器
真实服务可能有多名员工、优先级、预约、批量处理、休息和离队客户。到达可能成群,服务时长也可能遵循别的分布。这些都会改变公式及应对方式。这里不是网站、医院、商店或客服中心的实测数据。
可以带走的是机制:需求有波动时,系统需要忙碌过后的恢复空间。规划能力应研究实际工作量和重要的等待体验,包括尾部延迟。高利用率看起来高效,却可能留下极少余地;合理目标不能只靠这个模型决定。