十次中六次成功,和一千次中六百次成功,都是60%。
设想一个成功概率固定为0.6的虚构二选一过程。实验创造这个世界,所以知道真值,观察者却只看到成功和尝试。两组各十次的结果可能差很多。独立样本增加,结果通常更集中,即使屏幕上的百分比看起来仍一样简单。
分母也是证据的一部分。
60%没有说完的话
6/10和600/1,000的比例完全相同,运算却隐藏了样本量。改变一个结果,前者移动十个百分点,后者只移动0.1个百分点。因此,相同的比例未必具有相同精度。
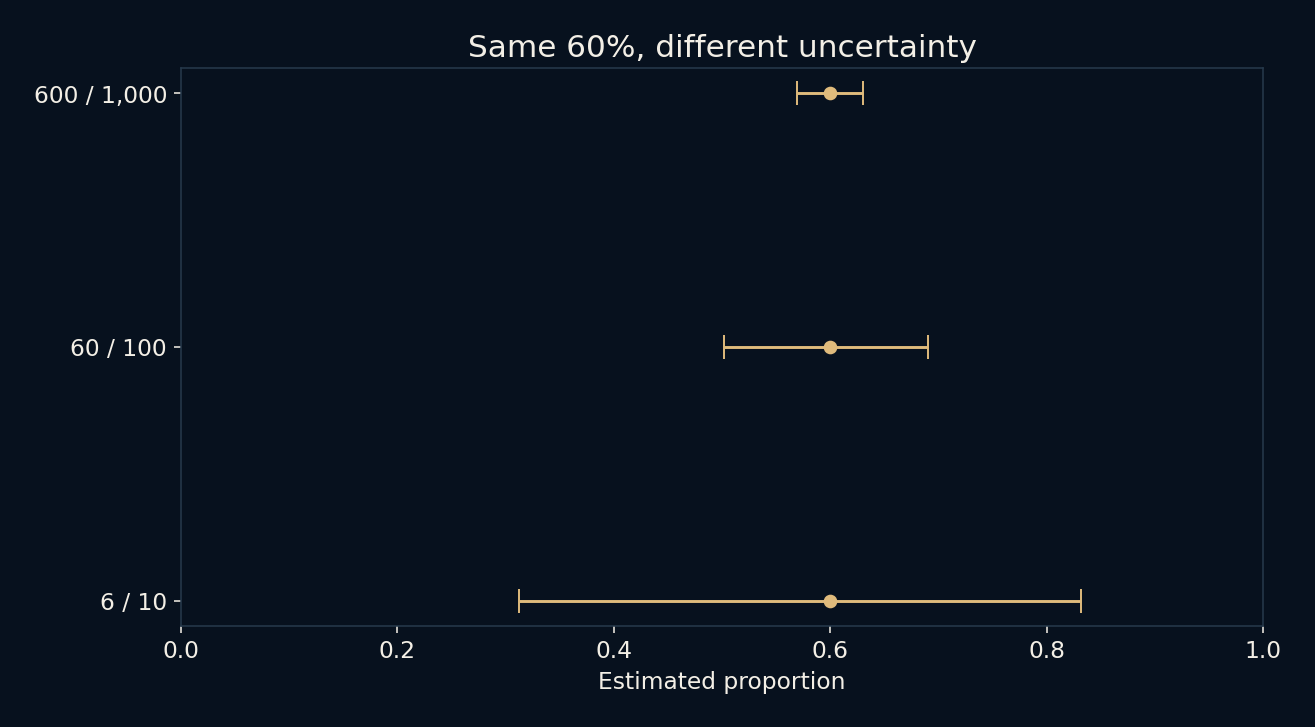
实验用95% Wilson区间比较6/10、60/100和600/1,000。它同时调整中心与宽度,而非简单围绕样本比例画对称带。在接近0或1时,这种方法也能保持合理边界,不会像不受限近似那样越出概率范围。
宽区间是一种有用的坦诚
6/10的区间约31.27%至83.18%,60/100约50.20%至69.06%,600/1,000约56.93%至62.99%。三者都显示60%,区间却让精度差异显现,不需要靠多写小数位制造精确感。
这些区间属于独立二元试验模型下的一种程序。通常的频率学解释不是“固定未知比例有95%概率落在本次区间里”,而是反复抽样时,程序力求约95%的覆盖率。图形像一团概率云时,这个区别很容易丢失。
让世界重来很多次
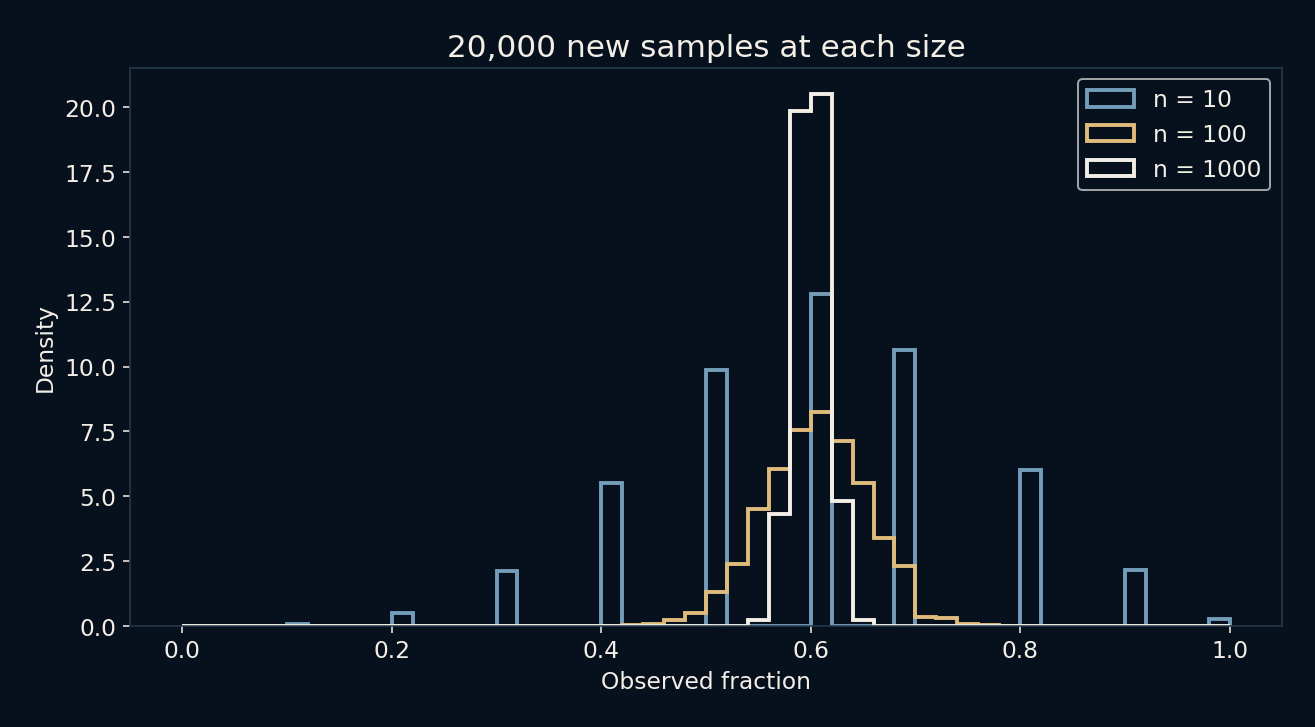
脚本在三种样本量下各生成20,000组独立样本,真实成功概率始终0.6。十次尝试的比例分散,一千次的比例则更集中在0.6附近。直方图展示反复抽样的行为,不是在说一个已观察样本同时包含许多现实。
区间覆盖0.6的实测比例分别为98.33%、94.73%、95.16%。标为95%的方法,在每种样本量和真值下未必恰好达到95%。二元计数只能落在离散网格上,模拟本身也存在有限抽样波动。
四倍样本,不是四倍精度
对于远离边界的独立二元观察,常见标准误差与样本量平方根的倒数成比例。因此,要把这类不确定性大致减半,通常需要约四倍观察,而不是两倍。Wilson公式还包含有限样本修正。
平方根关系解释了为什么小样本再添几条信息很有帮助,而大研究再压缩一点误差却很昂贵。这是模型规律,不保证每添一个结果,估计就更接近真值。某条更长的序列也可能暂时走远。
错误的样本,再多也仍有问题
实验直接保证独立性和固定概率。真实调查可能偏重某群体、重复访问同一个人、遗漏不回应者,或中途修改问题。错误抽样模型给出的狭窄区间,也可能只是对有偏答案很自信。样本量无法单独修复这些问题。
相信巨大分母前,先问观察如何选取,以及是否真正带来新信息,再选择适合设计与决策的区间。小样本不是毫无价值,只是在这个模型下不够精确。展示不确定性,比假装一个整齐百分比已经说完一切更诚实。