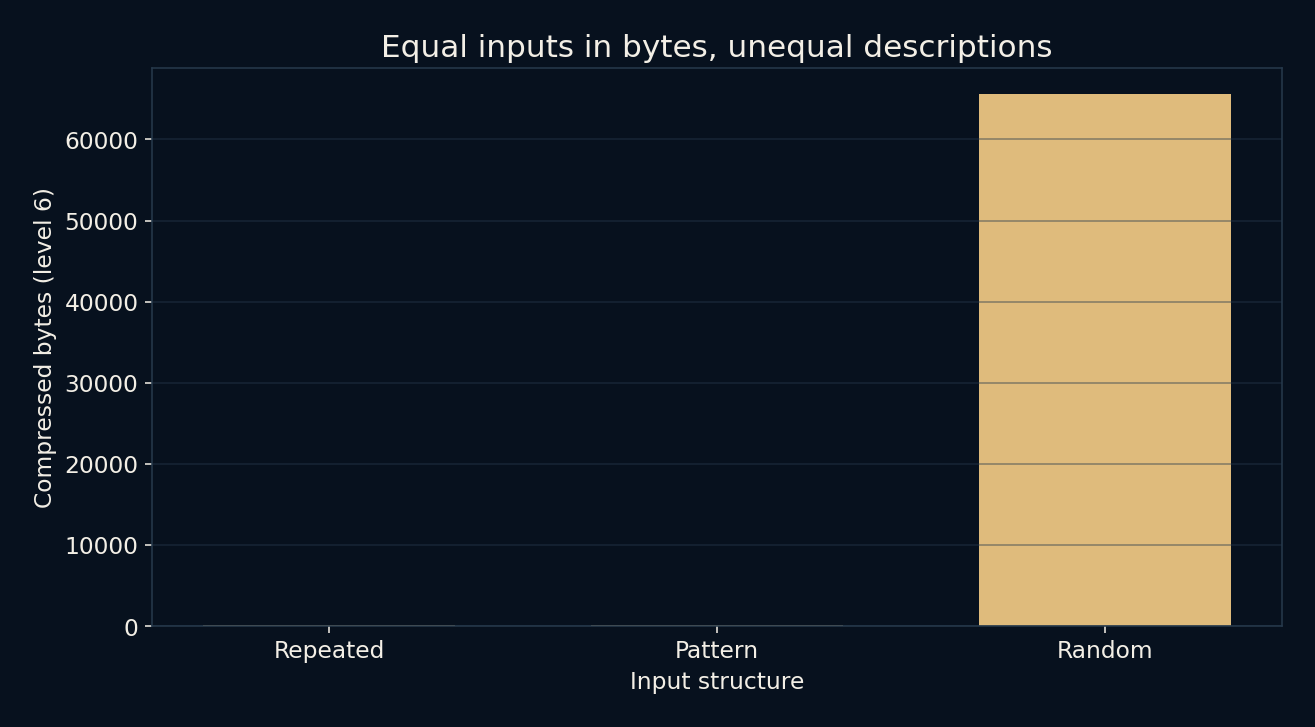
三份输入都为65,536字节,压缩后分别85、162和65,562字节。
第一份反复写A,第二份反复写ASTERXOR|并截到相同总长度,第三份是固定种子的伪随机字节。实验用zlib级别6压缩三者,再全部解压。起始长度相等,输出差异巨大,而恢复的每个字节仍与源数据一致。
机会藏在模式里,不只藏在数据量里。
重复段落不必再写一次
如果消息反复出现同一句话,紧凑描述可以指向之前的位置,并说明复用多少。zlib流内部的DEFLATE结合重复字节序列引用,以及给符号分配高效位模式的编码。解码器照着描述恢复原内容。
这是一种无损约定。实验比较完整解压字节串是否相等,不是看起来像不像。没有图像质量档位、视觉容差或被舍弃细节。只有原输入完全恢复,缩短描述才算成功。
结构改变结果
级别6下,重复A变成85字节,重复九字节模式变成162字节。伪随机数据变成65,562字节,比原65,536字节略大。测量的是含格式开销的完整zlib输出,不是假定的纯压缩载荷。
两份规律输入也不一样大。压缩不是简单数出现了几种字节;重复序列的排列和长度、编码选择、流格式都起作用。它们都可预测,却不必在这个编码器里拥有同样长的描述。
文件更大,也可能完全正确
看似独立的字节通常较少提供通用压缩器能利用的重复。编码器仍需合法的流、框架和完整性信息。本例于是大了26字节。程序并未损坏输入或解压失败,只是节省不足以抵消开销。
这一个样例不证明生成器产生真随机,也不说明每份看似随机的数据都增加相同字节。压缩器不是通用随机性检验器;表现取决于它能描述哪类结构,以及有多少数据可看。
更强设置不会凭空造出规律
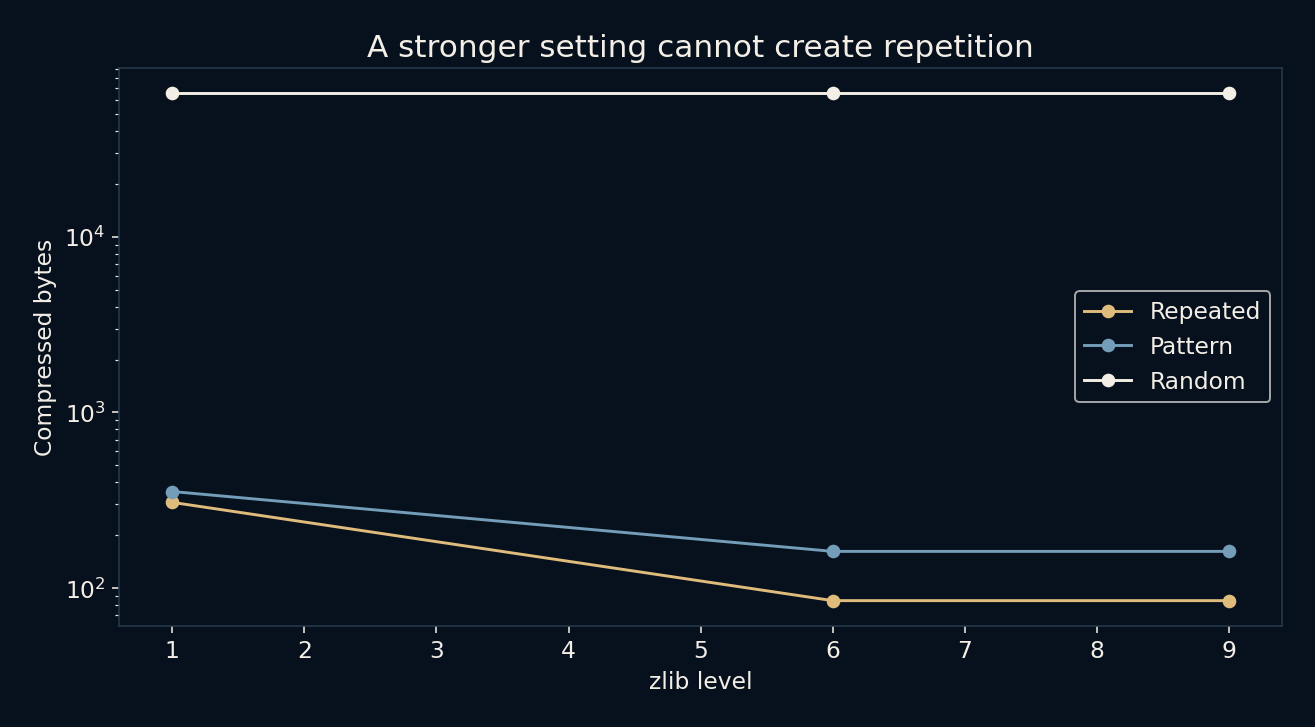
脚本还测试级别1、6、9。重复A分别308、85、85字节,重复模式355、162、162,伪随机则始终65,562。本次三例从6调到9,长度都没有变化。
级别指导编码器取舍,不是保留信息的百分比,所有设置仍无损。这里只测大小,没有测CPU时间或内存,不能据此判断真实任务哪个档最快最便宜。旋钮可以更努力寻找机会,却不能给本来无规律的输入创造机会。
无损格式不可能让一切都缩小
不可能给所有固定长度二进制输入各分配一个独一无二的更短描述,因为更短描述的数量不够。若要完全恢复,有些输入必须保持大小或变大。真实格式还需要可用的结构,也会增加成本。
计数道理不能预测某份文档压缩多好,却说明“每个文件都变小,内容一点不变”不是软件能普遍兑现的承诺。应测试实际材料,必要时保留原始版本,并比较完整存储大小。规律创造机会,格式决定能用掉多少。