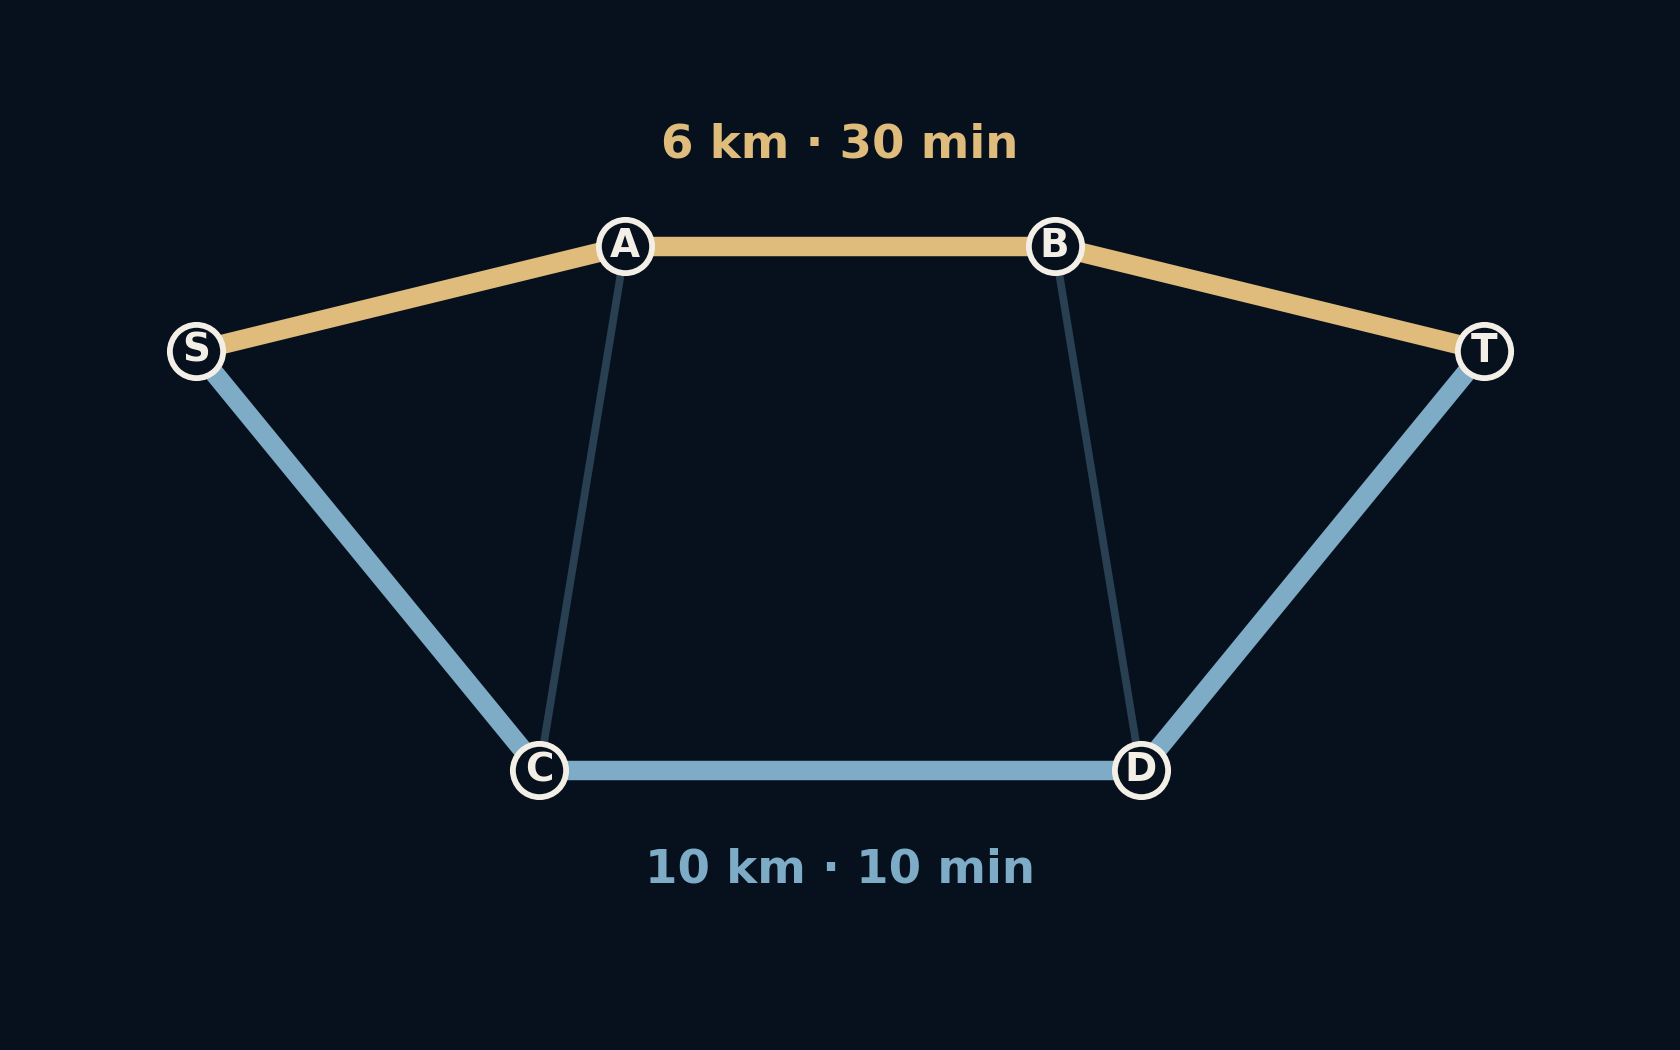
路程多了四公里,却早到了二十分钟。
这听起来像导航出了错,直到地图上多了一组数字。距离描述要走多少路;时间还取决于这些路能走多快。在这个刻意构造的小网络里,只要把问题从“距离最短”换成“用时最少”,答案就会完全不同。
先说清楚“好”的代价是什么,才谈得上最佳路线。
两个都说得通的答案
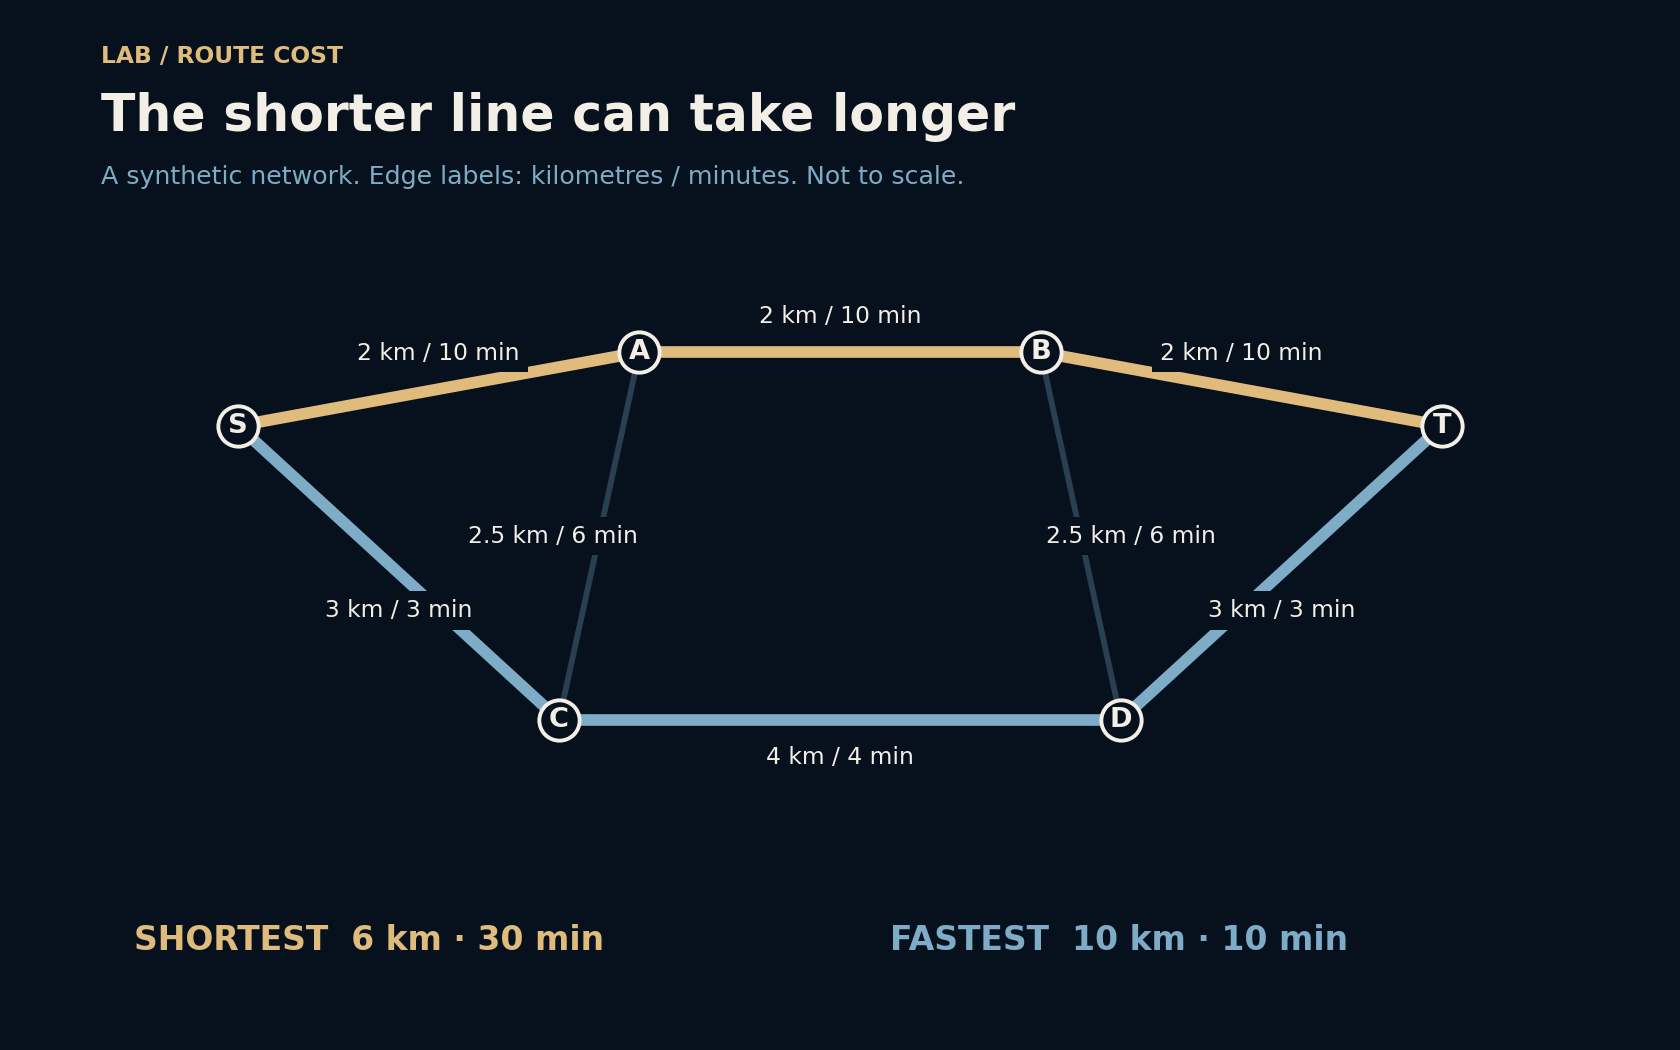
从S出发,到T结束。上方路线经过A和B,由三段各两公里的道路组成,总长六公里。每段的假定速度都是12公里/小时,因此各需十分钟。下方路线经过C和D,总长十公里,但假定全程速度为60公里/小时,所以整条路线只需十分钟。
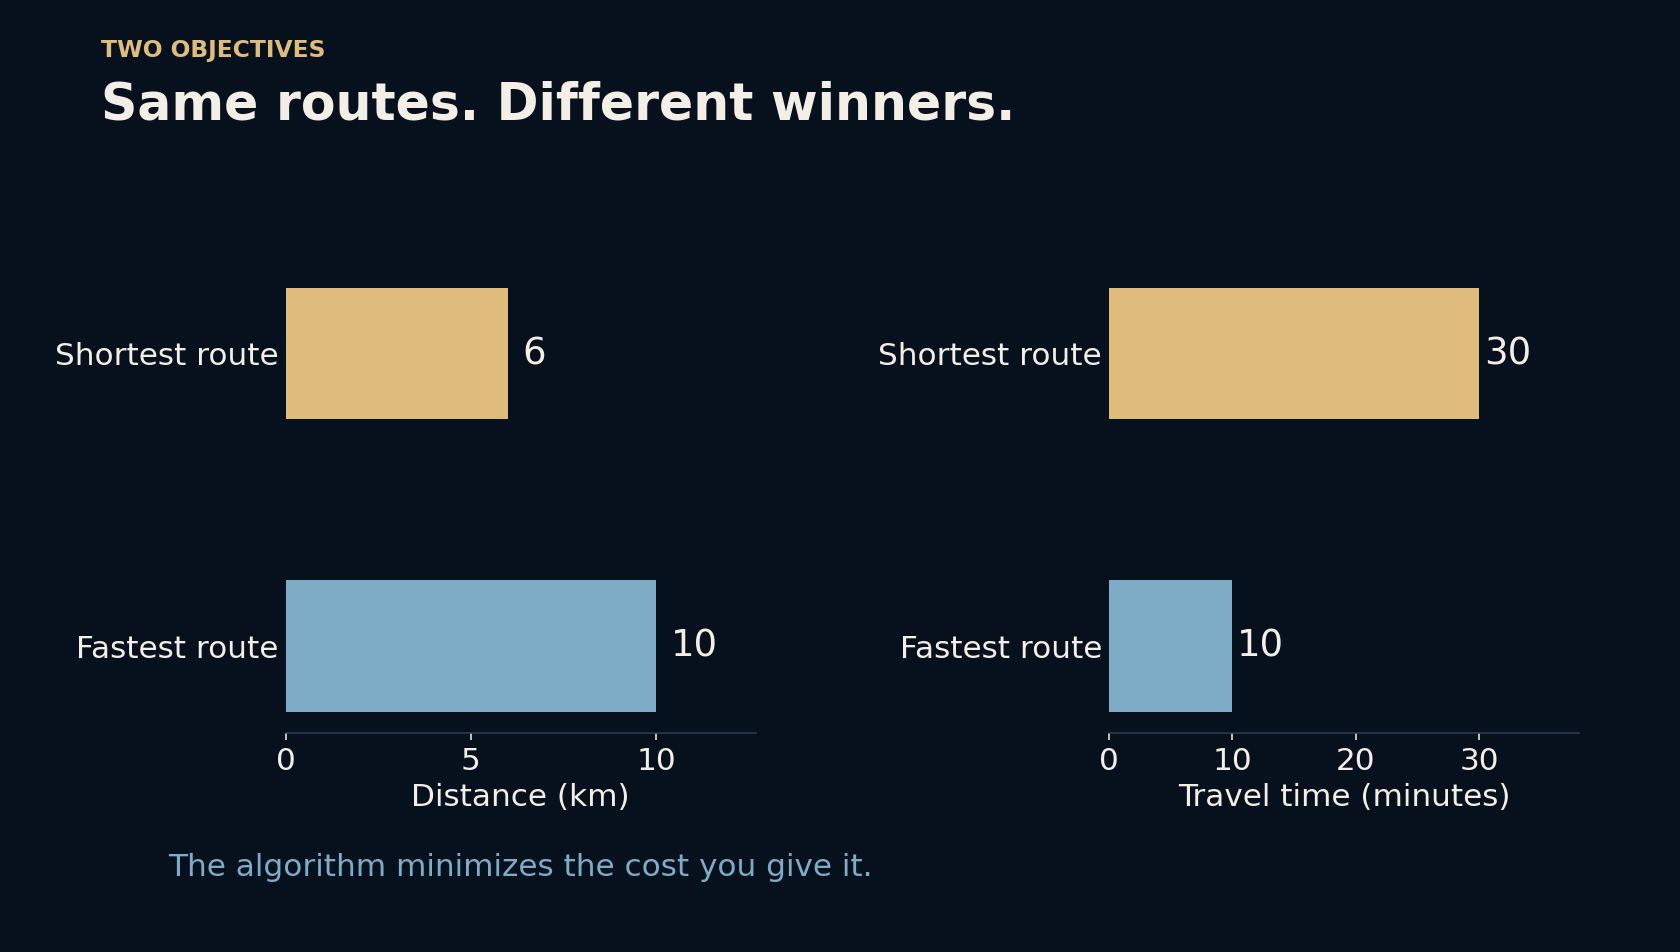
于是,距离最短的路线需要三十分钟,时间最短的路线只需十分钟。两个答案并不矛盾,因为它们回答的是不同的问题。图中还有两条连接上下路线的道路,让它成为一个真正的网络,而不只是两条互不相通的线。稍后改变一个假设时,这两条连接就会派上用场。
把地图变成一份成本清单
对图算法来说,路口是节点,可通行的连接是边。每条边都有一个权重,也就是使用这条连接的成本。第一次计算用公里数作为权重,第二次用分钟数:距离除以速度,再乘以六十。图上线条的几何形状并不参与计算。
这一点很容易被忽略。画得笔直的线,不等于实际行程更短。我们的图没有按比例绘制,距离都是明确设定的。同样,真实导航需要知道道路如何连接、有哪些通行限制,而不只是测量地点之间的直线距离。一座看起来很近的桥,也可能无法从你所在的河岸上去。
Dijkstra从当前最便宜的地方向外探索
Dijkstra算法把起点S的成本设为零,其余节点的成本暂时未知。它不断选出尚未确定、但当前总成本最小的节点,检查它通向其他节点的连接。如果发现了更便宜的走法,就更新相邻节点的成本,并记下是从哪个前驱节点得到这个改进,最后据此还原路线。
这套方法要求边权重非负。沿着路径继续前进,不会抵消已经付出的成本,因此当终点的最优成本被确定时,它就是这些假设下的最小值。算法本身不理解迟到、风景或方便。那些偏好必须在搜索开始前,通过模型和权重表达出来。
多出十八分钟,局面就变了
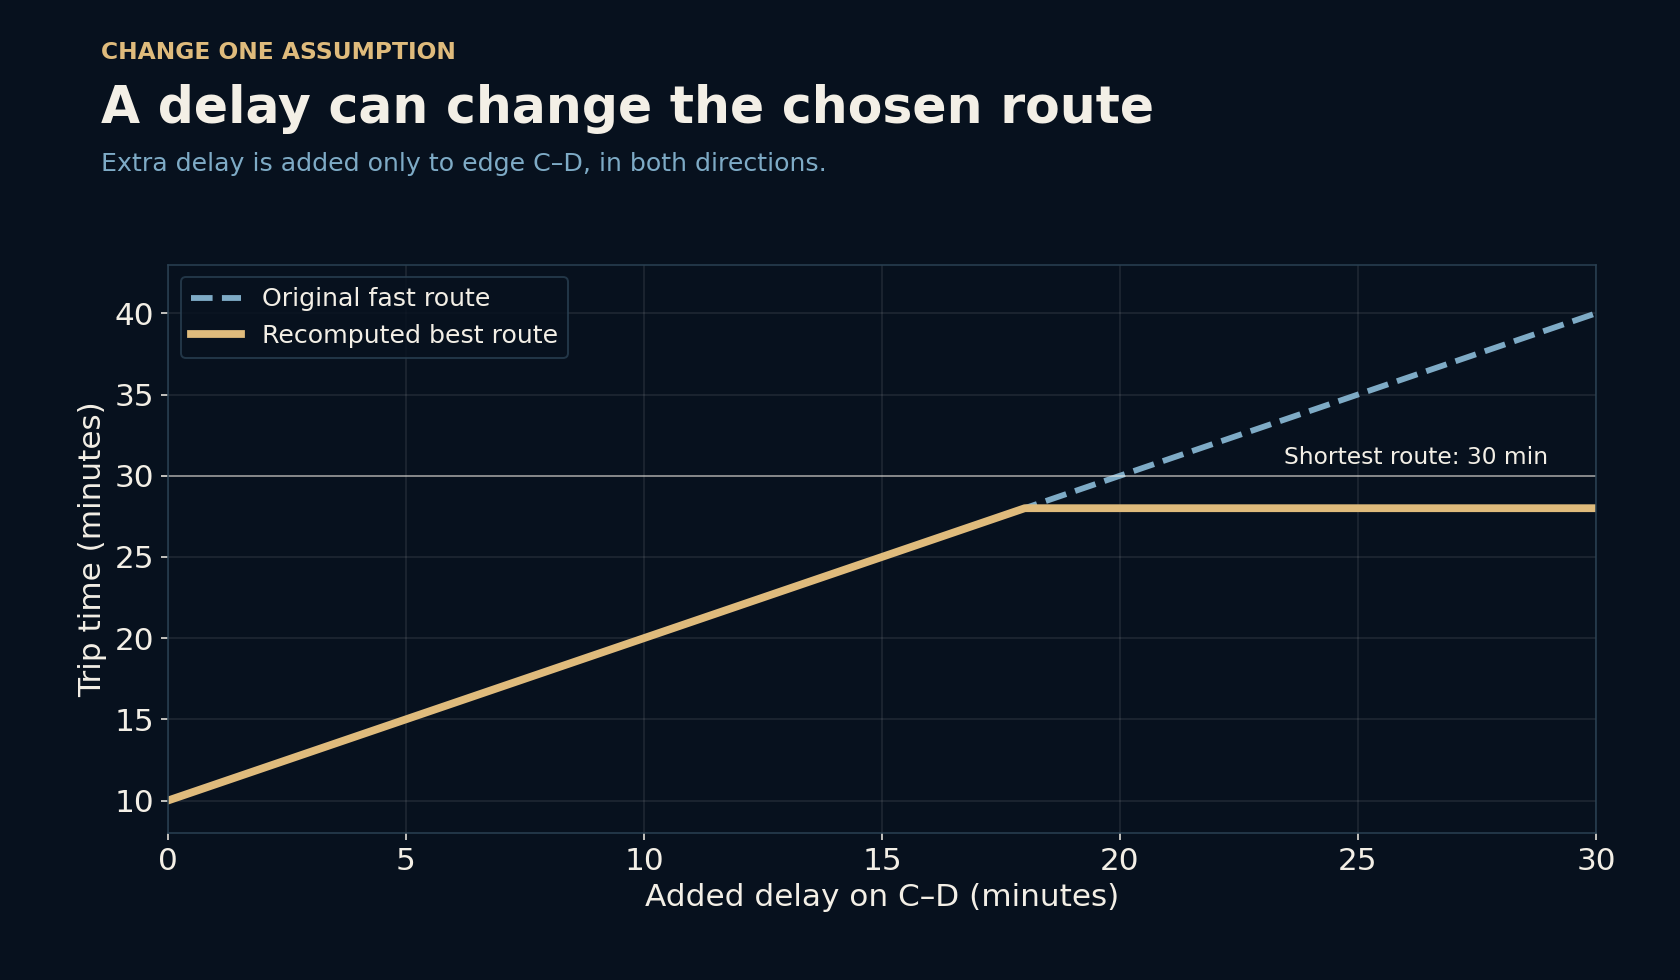
现在给C–D这条连接增加延迟,再计算一次。原先最快的路线需要十分钟加上这段延迟。当延迟达到十八分钟,它会与另一条路线打平,都是二十八分钟。延迟继续增加后,最优路线可以通过连接道路绕开C–D,改走S–C–A–B–D–T,总长十三公里。
这解释了为什么先前的优胜路线未必一直领先。增加二十分钟延迟后,沿用原来的最快路线会花三十分钟;重新搜索则能找到二十八分钟的走法。不过,结果仍取决于更新后的假设。这里的延迟是对两个方向都适用的固定附加时间,并不是会随行程变化的交通预测。
一个数字,藏着很多偏好
有人希望少换乘,有人想避开收费道路,有人需要无障碍路线,也有人愿意走一条更慢但感觉更安全的路。有些条件应当在搜索前直接排除不可用的边;另一些可以转化为成本,或作为不同方案交给出行者选择。把所有因素合成一个分数是可行的,但换算本身就是决策:为了免交一次通行费,你愿意多花几分钟?
就连“最快”也需要定义。平均用时最少的路线,未必最有可能让你赶上某个截止时间。这个固定速度的例子没有不确定性,因此不能回答后一种问题。它只是把一个清楚的区别讲明白,并不声称导航的全部工作就是几次加法。
相信答案之前,先看看它在优化什么
当两个导航建议不一致时,先比较它们各自在最小化什么,又知道哪些限制。出发时间、出行方式、道路封闭情况,以及估算是否包含步行和等待,都值得检查。这些信息可能比屏幕上那条线看起来有多直接更重要。
这个习惯也适用于地图之外。配送方案、网络连接、生产步骤,都可以表示为一连串选择构成的路径。搜索结果可以完全正确,目标却仍然不完整。在改进算法之前,先问问它计算的成本是不是你真正关心的东西,往往更有价值。