같은 256개 수에 한 방법은 16,973회, 다른 방법은 1,728회 비교했다.
두 로컬 프로그램 모두 올바르게 정렬했으며 더 빠른 컴퓨터를 쓴 쪽은 없다. 하나는 정렬된 앞부분에 새 항목을 삽입하고 다른 하나는 반으로 나눠 정렬한 뒤 합친다. 알고리즘 설계의 작은 예다. 특정 종류의 일을 세며 실측 속도 향상을 주장하지 않는다.
좋은 알고리즘은 기계가 답하기 전에 질문을 줄일 수 있다.
손의 카드를 한 장씩 정리하기
삽입 정렬은 숫자 카드를 정리하는 것과 같다. 다음 항목을 집어 왼쪽 항목들과 비교하고 더 큰 것들을 밀어 자리를 찾는다. 삽입할 때마다 앞부분은 정렬된다. 입력 순서가 이미 좋으면 아주 적은 일만 할 수 있다.
카운터는 삽입 키와 기존 키를 비교할 때 증가한다. 반복 경계 검사는 키 비교가 아니다. 값 이동, 목록 복사, 메모리 할당도 세지 않는다. 단위를 정의하지 않으면 “연산”이라는 같은 이름의 두 그래프가 서로 다른 일을 측정할 수 있다.
정렬된 두 반쪽 합치기
병합 정렬은 목록을 단순해질 때까지 반으로 나누고, 정렬된 조각의 맨 앞 항목을 비교해 합친다. 작은 쪽을 출력하고 그쪽만 전진한다. 한쪽이 비면 다른 쪽 나머지는 추가 키 비교 없이 복사한다.
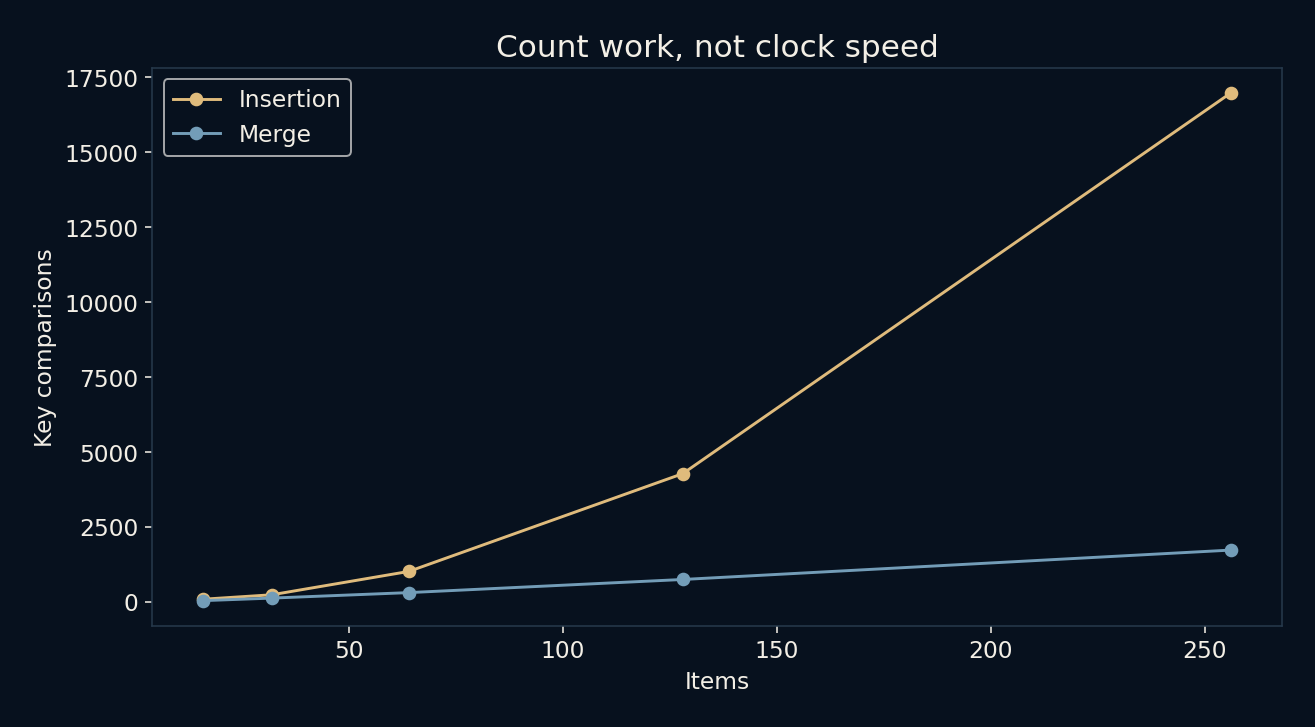
서로 다른 정수 256개의 고정 무작위 순열에서 병합은 1,728회, 삽입은 16,973회 비교했다. 16개에서는 각각 42회와 90회다. 선택한 입력의 실제 횟수이지 모든 목록을 예측하는 공식이 아니다. 두 결과 모두 정확한 오름차순 정수와 대조했다.
반복 순회와 반복 단계
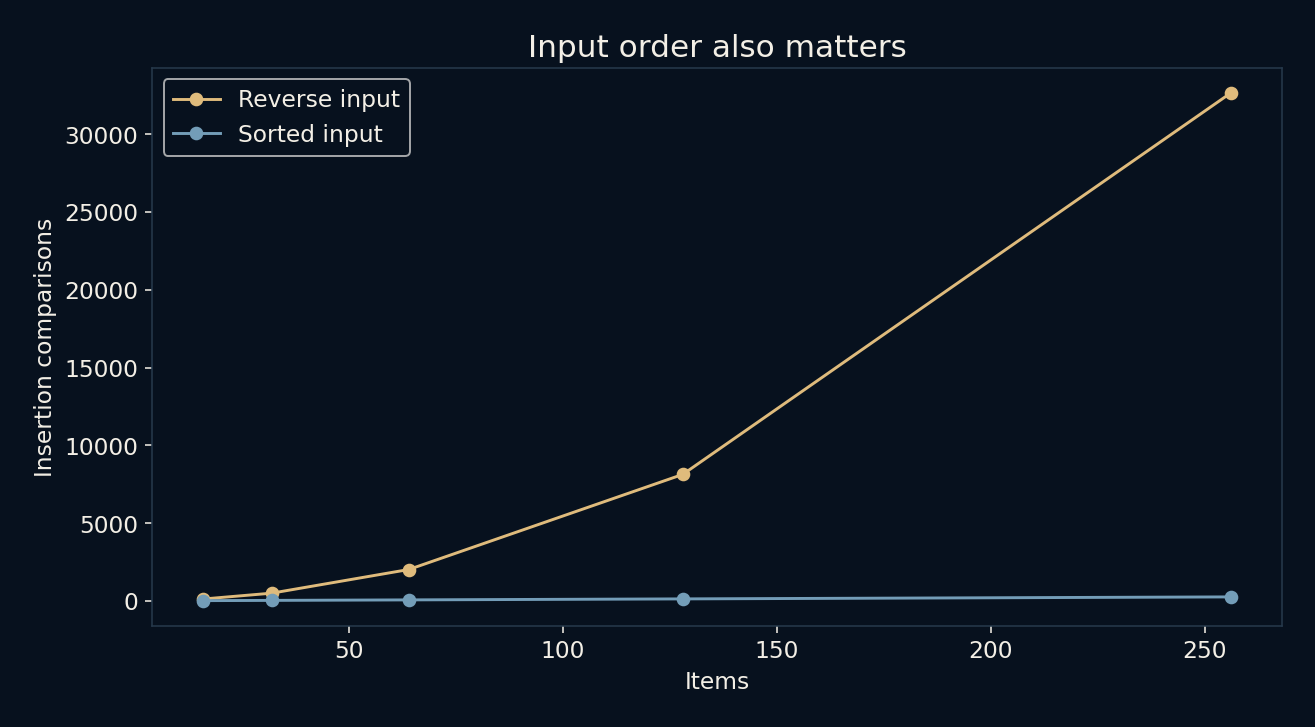
역순에서는 새 키마다 앞의 모든 키와 비교하므로 n개에 n(n−1)/2회다. 256개면 32,640회다. 병합은 여러 분할 단계를 거치며 단계마다 항목에 걸쳐 합치는 일을 한다. 익숙한 제곱 증가와 n-log-n 증가라는 설명이 여기서 나온다.
증가 표기는 명시한 조건에서 비용이 커지는 방식이지 초시계 수치가 아니다. 상수, 데이터 표현, 구현 세부도 중요하다. 교육용 코드에서 비교가 적다고 모든 작은 목록에 최선은 아니다. 각 단계를 빠르게 하는 것과 문제가 커질 때 단계를 덜 요구하는 것은 다르다.
이미 정렬됐다면 다른 이야기
같은 삽입 함수도 오름차순 256개에는 255회만 비교한다. 새 항목이 바로 뒤에 들어가기 때문이다. 역순에는 32,640회다. 알고리즘이나 하드웨어를 바꾸지 않고 입력 배열만으로 큰 차이가 난다. 단일 비용 수치는 이를 숨긴다.
그래서 오름차순과 역순은 고정 난수 순열과 따로 그렸다. 난수 예는 서로 다른 정수이며 크기별 한 번의 추출이다. 구현 비교용으로 유용하지만 모든 순열의 완전한 평균 연구나 중복이 많은 실제 데이터의 대표 표본은 아니다.
비교가 비용의 전부는 아니다
실무 정렬에는 메모리, 이동, 비싼 비교 함수, 안정성, 부분 정렬 구조가 중요하다. Python 내장 정렬은 적응적이고 안정적인 정교한 구현으로 이 두 교육용 함수와 다르다. 이 그래프가 내장 정렬을 바꿀 근거는 아니다. 내장 정렬 시간은 측정하지 않았다.
그래프는 계산 자원을 더 사기 전에 물을 질문을 준다. 피할 수 있는 일을 반복하고 있는가? 문제를 다르게 조직하면 반복을 줄일 수 있는가? 이후에는 단순 카운터가 빠뜨린 비용까지 실제 작업에서 측정해야 한다. 계산 방식이 실제 과제와 맞을 때 알고리즘 통찰이 유용해진다.
더 읽어 보기
Princeton Algorithms: elementary sorts ↗Princeton Algorithms: mergesort ↗Python: sorting techniques ↗공식 문서와 함께 읽으면 좋은 자료입니다.