两个缓存各放三项,一个命中四次,另一个两次。
全部负载就是ABCABDABCDAB这一串字母。每个字母请求一个虚构对象,两份缓存从空开始。已在其中叫命中,需要载入叫未命中。唯一差别是淘汰规则。小序列让每次决定都能检查,而不假装测到了真实电脑速度。
缓存是用有限空间做出的预测。
若全记住,就不用争论
可能请求四种对象,却只有三个位置。开头A、B、C都未命中,因为缓存为空。之后三个槽已满,D到来时必须有人离开。问题不在于要不要记忆,而在于哪段过去更值得留下。
模型把对象视为等大,把每次未命中视为同类事件,没有赋予下载时间、存储价格或读取成本。现实对象与后果通常不等,但先拿掉这些因素,才能单独比较替换规则。
进入顺序和使用顺序不同
先进先出FIFO淘汰最早进入的对象,命中不会刷新它的排位。最近最少使用LRU淘汰距离上次请求最久的对象,即使命中没有载入新对象,也会更新新近程度。
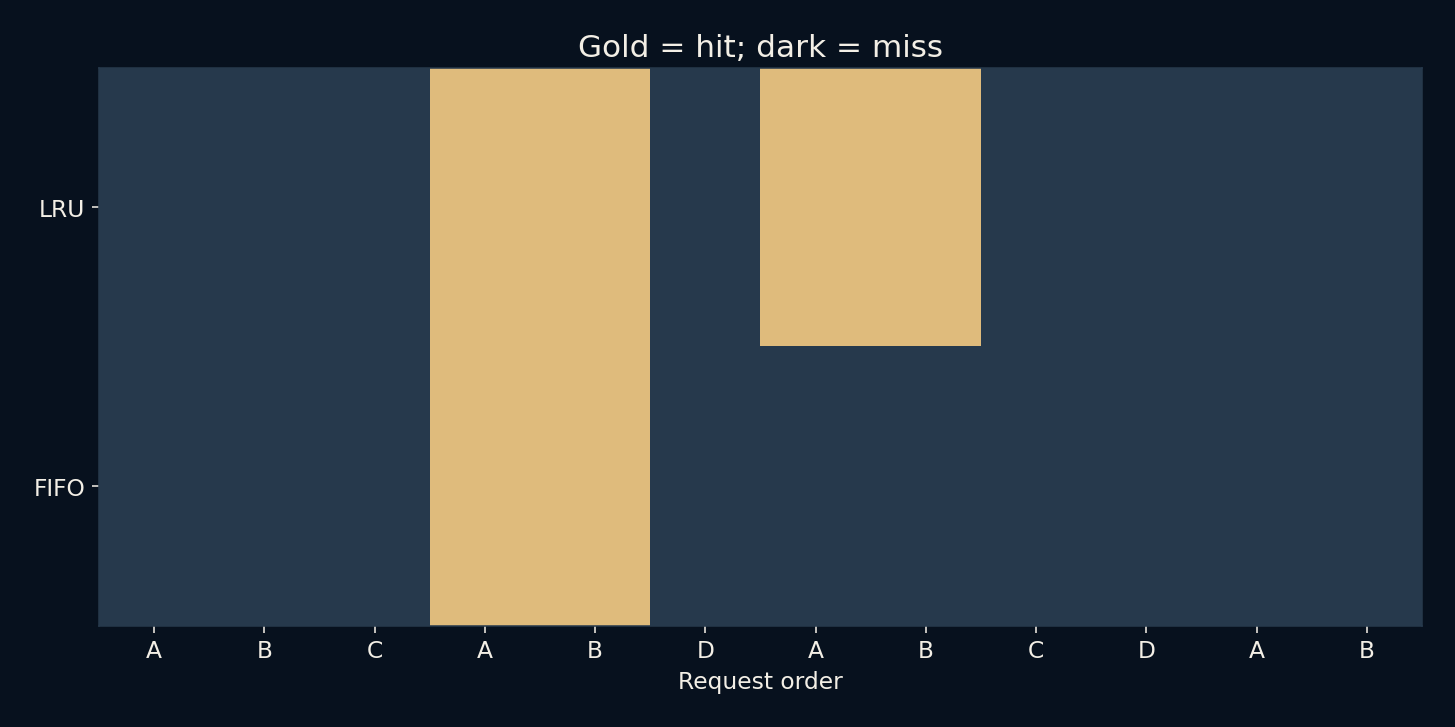
开头ABC之后又请求A、B,两种方法都命中。FIFO仍认为A最早进入,LRU却认为C最久没用。随后D到来,FIFO删A,LRU删C。这个分歧改变了接下来再次请求A、B的结果。
优势有具体原因
12次请求中LRU命中4次、FIFO2次,分别为33.3%和16.7%。LRU获益于A、B短时间内再次使用。序列特意让这个区别可见,并不是用户浏览或处理器访存的随机样本。
最后四次C、D、A、B,在三槽主实验里两种方法全部未命中。只有未来真的复用被保护的对象,新近使用才有价值。请求不断轮换到超过容量的对象时,预测可能失效。本例既有短暂复用,也有随后毫无命中的一段。
多一个位置,故事就变了
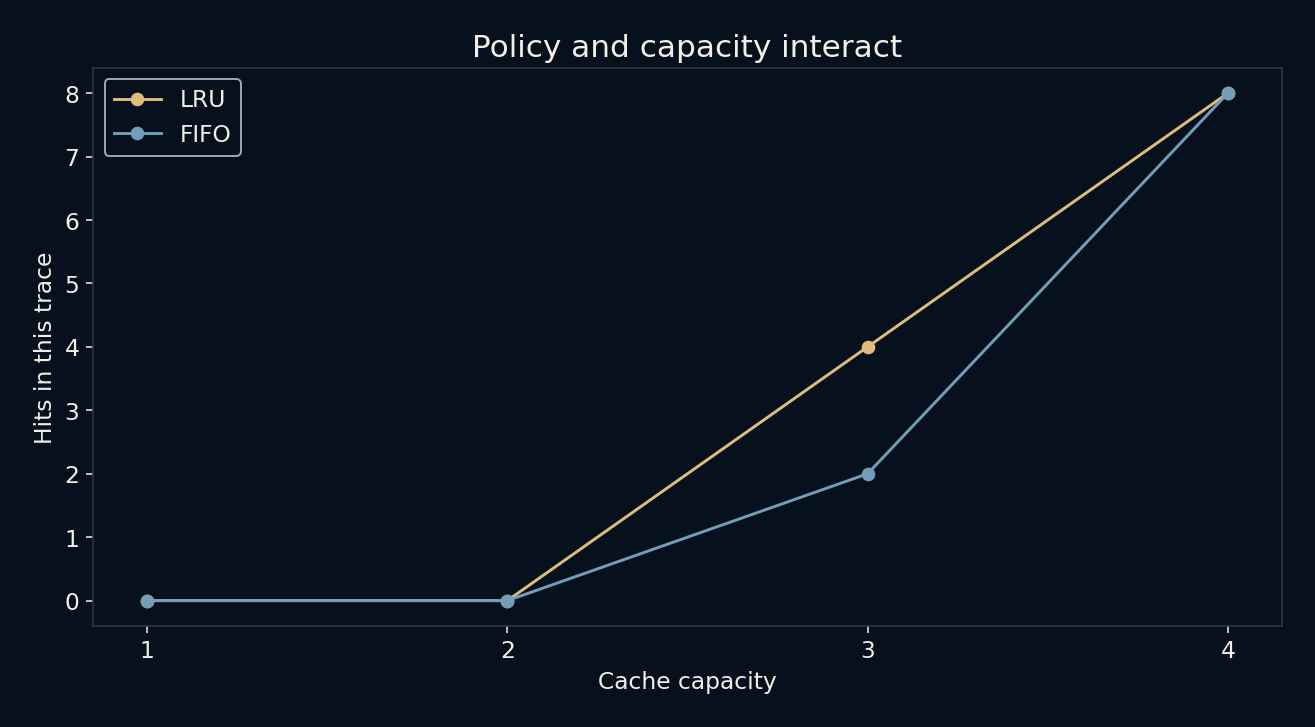
脚本用一到四个位置重放同一序列。四槽能同时留住全部对象,首次载入四次之后,两种策略都得到八次命中。无需淘汰后,原先差异消失。容量和策略相互作用,并非各自提供独立保证。
这只适用于四个不可变键和固定可用容量的负载。现实扩大缓存可能争夺其他工作的内存,大对象也可能挤掉多个小对象。容量图应同时交代负载和对象大小,横轴才有意义。
记住的不一定还有效
缓存还要知道结果何时过期。若源内容已变却没通知缓存,即使命中率完美,也可能给错答案。到期、验证和主动失效关乎正确性;替换策略主要决定空间满时留下哪份已有副本。
这里没有模拟新鲜度机制。字母对应不变对象,淘汰只从模拟缓存移除。可带走的是三个分开的疑问:留什么、有效多久、取回代价多少?最近使用规则只能不完美地回答第一项,不能一次回答全部。