가장 가까운 점은 쉽게 계산할 수 있습니다. 흥미로운 부분은 공간을 고르는 일입니다.
물건마다 측정값이 두 개뿐인 작은 목록을 생각해 보세요. 찾는 조건을 하나의 점으로 표현하고, 그 점에 가장 가까운 물건을 추천합니다. 대화나 성격 검사, 거대한 모델은 필요하지 않습니다. 하지만 이 단순한 시스템에도 중요한 설계 결정이 들어 있습니다. 숫자는 각 측정값이 얼마나 중요해야 하는지 알려 주지 않습니다. 물건이 그대로여도 추천은 바뀔 수 있습니다.
거리 공식은 정확해도, 거리의 의미는 여전히 선택의 문제입니다.
측정할 수 있는 공간에 물건을 놓기
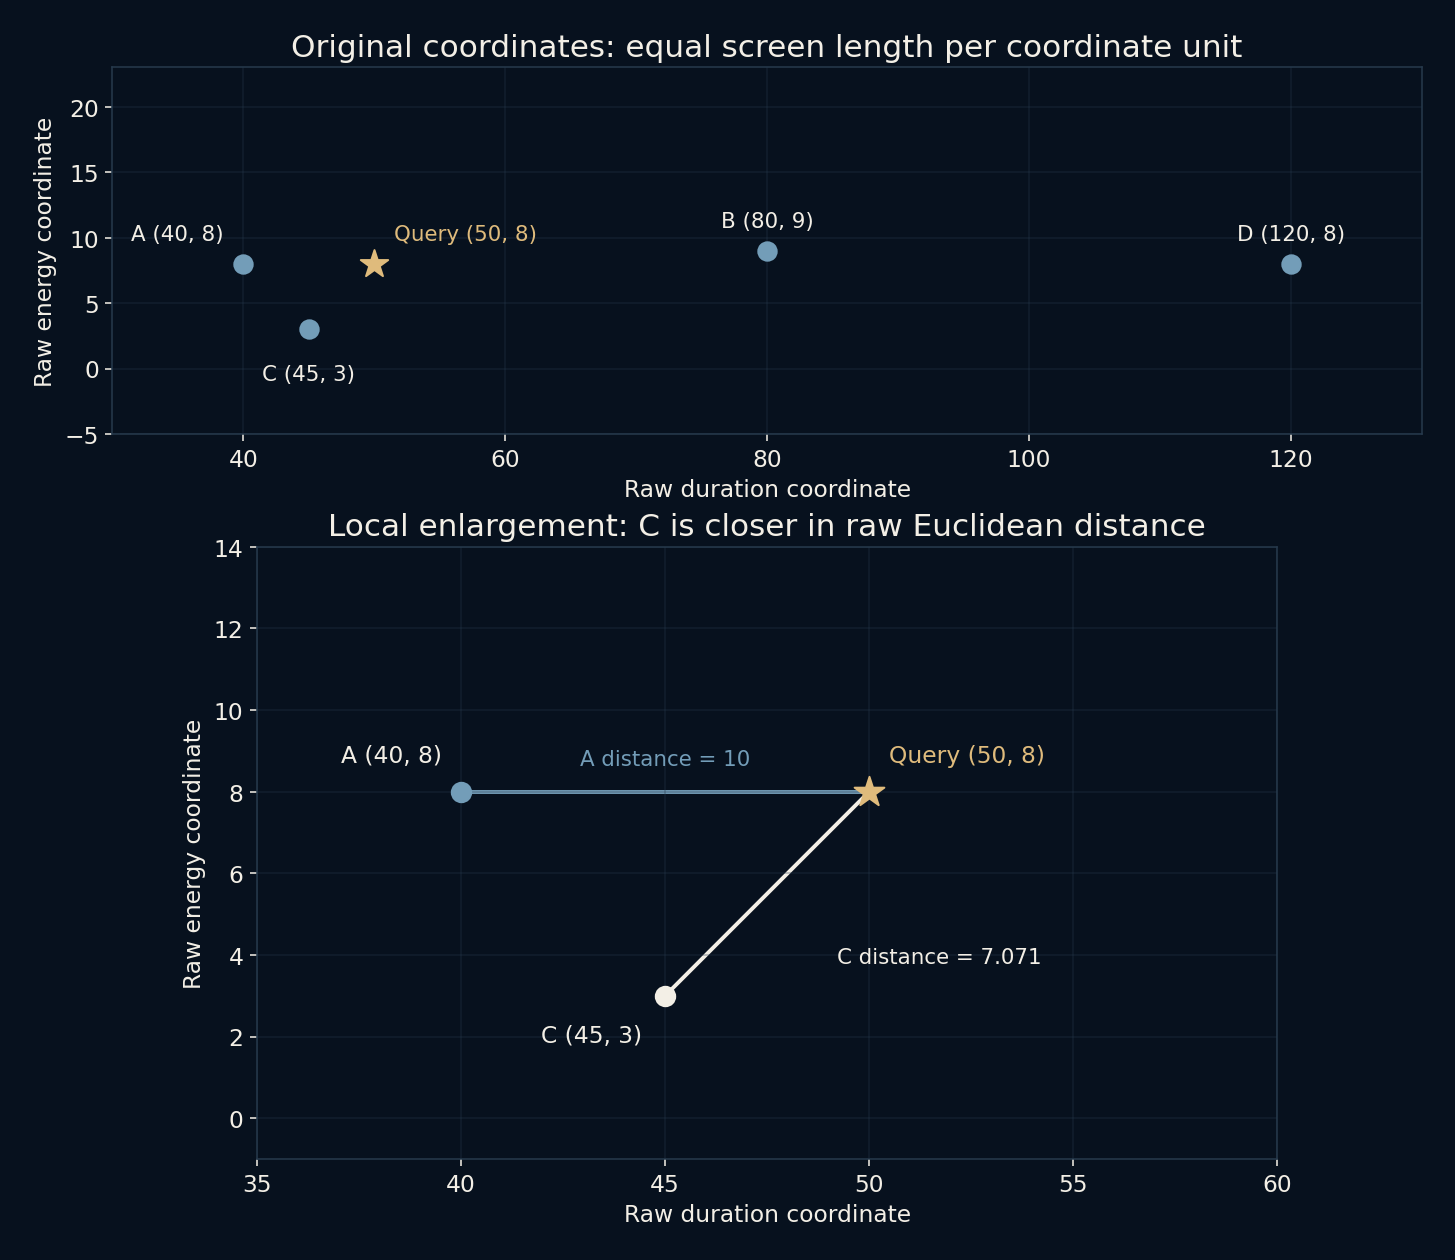
이 예제의 질의점은 (50, 8)입니다. A부터 D까지의 물건은 각각 (40, 8), (80, 9), (45, 3), (120, 8)에 있습니다. 좌표는 가상의 속성 두 개라고 생각하면 됩니다. 실제 취향이나 상품 가격이라는 이름은 붙이지 않았습니다. 필요한 것은 수치 범위가 다른 특성이지, 관찰한 적 없는 고객 이야기가 아닙니다.
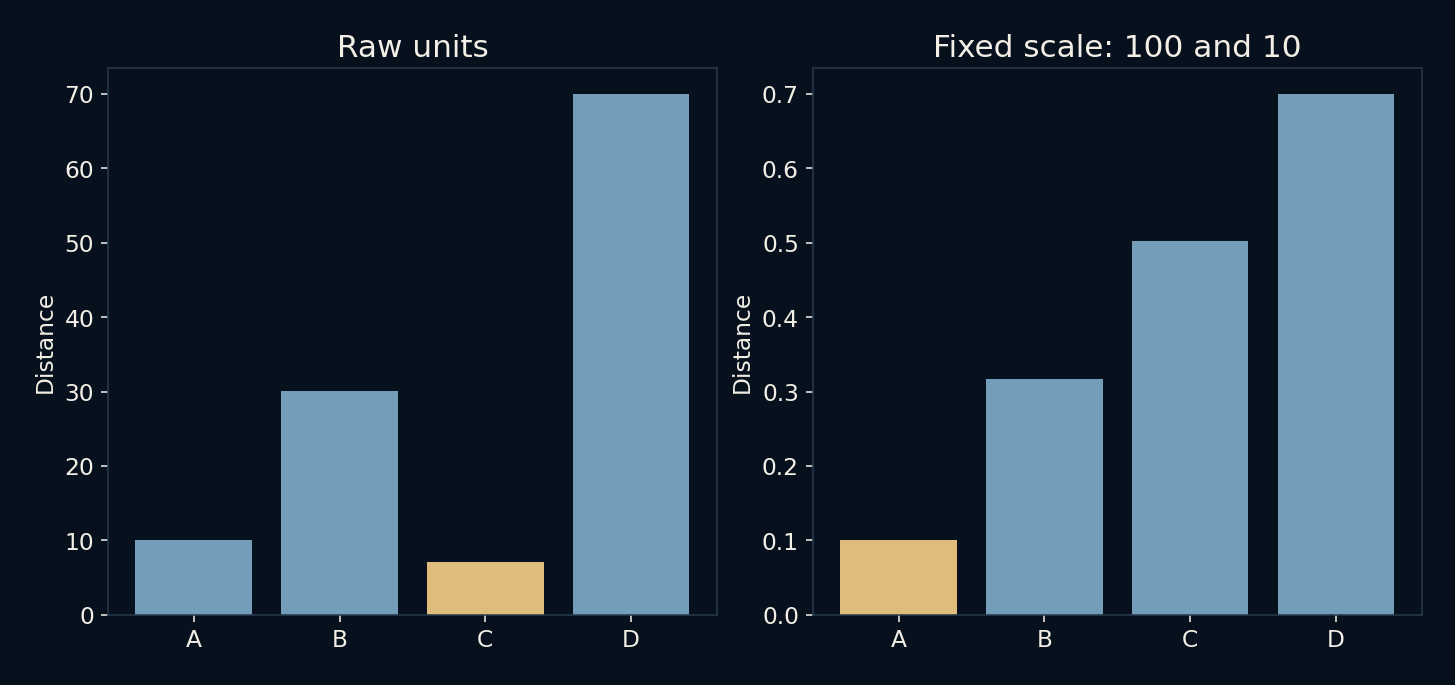
일반적인 유클리드 거리는 각 좌표의 차이를 제곱해 더한 뒤 제곱근을 구합니다. C는 약 7.07로, 거리가 10인 A보다 가깝습니다. A의 두 번째 좌표는 정확히 같지만 첫 번째 좌표가 10만큼 다릅니다. 두 좌표가 각각 5만큼 다른 C보다 전체 거리가 크게 계산되는 것입니다.
단위는 조용히 우선순위가 된다
수학적으로 틀린 답은 아닙니다. 문제는 두 축의 원래 단위를 동등하게 다루어도 되느냐는 것입니다. 한 특성의 변화 범위가 수백이고 다른 특성은 10 정도라면, 같은 수치 차이도 의미가 다릅니다. 같은 길이를 밀리미터로 쓰면 미터로 쓸 때보다 숫자가 천 배 커집니다. 물체는 그대로인데 조정하지 않은 거리는 달라집니다.
그래서 특성의 척도를 조정하는 일은 보기 좋게 정리하는 작업이 아니라 모델의 일부입니다. 비교하기 어려운 단위를 생각 없이 합친 시스템도 이미 선택을 했습니다. 숫자의 표현 방식이 중요도를 정하게 둔 것입니다. 보통 결과를 보는 사람에게 그 선택을 설명하지도 않습니다.
중요성을 유지한 채 단위만 바꾸는 검사가 유용합니다. 모든 물건과 질의의 첫 좌표를 1,000배 하고 해당 척도 나눗값도 1,000배 합니다. 확장 스크립트는 부동소수점 허용 범위에서 같은 거리를 확인했습니다. 좌표만 바꾸면 모형 자체가 달라집니다. 이 검사는 무해한 표기 변경과 특정 특성을 더 중요하게 보겠다는 결정을 구별합니다.
축을 다시 조정하면 다른 이웃이 선택된다
이번에는 첫 번째 좌표의 차이를 100으로, 두 번째를 10으로 나눈 뒤 거리를 계산합니다. A는 0.10, C는 약 0.5025가 되어 A가 가장 가까워집니다. B와 D의 거리는 각각 약 0.3162와 0.70입니다. 목록과 질의점은 그대로입니다. 거리에 부여한 의미만 달라졌습니다.
이 나눗값들은 예제를 위해 명시적으로 선택한 값입니다. 사용자에게 학습한 값도 아니고 새 답이 더 좋다는 증거도 아닙니다. 실제 시스템에서는 물리적으로 의미 있는 단위, 학습 데이터의 변동성, 검증한 선호 모델 등을 사용할 수 있습니다. 모두 가정을 포함합니다. 데이터 분포가 바뀌면 이전에 맞춘 척도도 다시 살펴볼 필요가 있습니다.
이웃은 우승자 이상의 정보를 줄 수 있다
가까운 물건 여러 개를 보여 주면 하나의 정답만 발표할 때보다 더 많은 정보를 얻을 수 있습니다. 거리들을 보면 첫 후보가 크게 앞서는지, 거의 동점인지, 모든 물건이 사실은 멀리 있는지 알 수 있습니다. 최솟값을 반드시 고르는 시스템은 형편없는 목록에서도 1위를 만듭니다. 가장 가깝다는 말만으로 충분히 유용할 만큼 가까운지는 알 수 없습니다.
실제 시스템에는 누락된 측정값과 동점을 처리하는 규칙도 필요합니다. 없는 값을 0으로 취급하면 측정값을 지어내는 셈이고, 그 특성을 제외하면 비교 공간이 바뀝니다. 어느 쪽도 사용자 몰래 일어나서는 안 됩니다. 여기서는 완전한 데이터와 동점이 없는 결과를 사용해 기하학적 효과에 집중했으며, 운영상의 문제까지 해결한 것은 아닙니다.
질의를 (500, 8)로 옮기고 나눗값 [100, 10]을 유지하면 충분히 가깝다는 말이 구체화됩니다. 먼 질의에서도 1위는 생기며 이번에는 D입니다. 거리는 3.8로, 원래 질의의 우승 거리 0.1보다 큽니다. 예시 수용 기준 0.2는 원래 질의는 받아들이고 먼 질의는 거절합니다. 이 기준은 학습으로 얻은 값도, 실제 목록에 권장하는 값도 아닙니다. 우승자 선택과 매칭 수용이 다른 결정이며 적합한 결과가 없다고 답할 수도 있음을 보여 줍니다.
깔끔한 공간에서 중요한 것이 빠질 수도 있다
기록한 축에서는 가까운 물건도 측정하지 않은 속성에서는 크게 다를 수 있습니다. 크기와 무게로 만든 추천이 특정 재료를 가장 중요하게 여긴다는 사실을 저절로 알 수는 없습니다. 특성을 더 많이 추가한다고 자동으로 해결되지도 않습니다. 불필요한 특성이 유용한 특성을 희석할 수 있고, 고차원에서는 이웃에 대한 직관도 덜 믿을 만해집니다.
모델은 어떤 차이가 중요한지에 관한 주장으로 이해하는 편이 좋습니다. 명확한 과제로 검증할 수는 있지만 예쁜 산점도만으로 평가할 수는 없습니다. 추천을 제대로 평가하려면 관련 사례와 결과가 필요합니다. 이 글에는 실제 선호도나 별도의 사용자 연구가 없으므로 만족도, 정확도, 전환율을 주장하지 않습니다.
설정 두 개 대신 전환점을 찾습니다
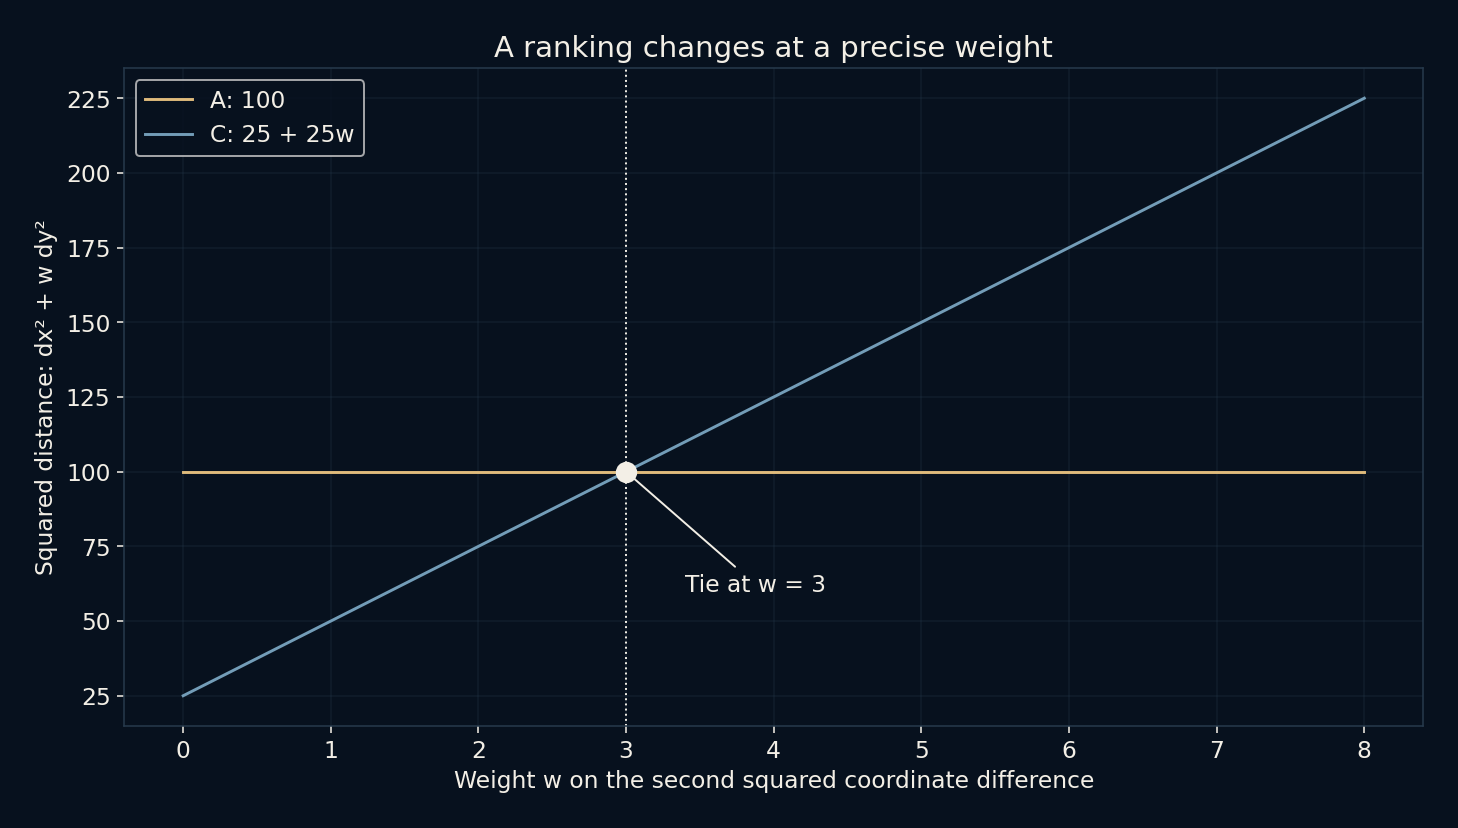
조절값 하나로 선택을 드러낼 수 있습니다. 첫 좌표 차이의 제곱은 그대로 두고 둘째에는 가중치 w를 곱합니다. A의 제곱 거리는 100, C는 25 + 25w이므로 w = 3에서 정확히 같습니다. 가중치 2에서는 C의 75가 A의 100보다 작고, 4에서는 C가 125가 되어 A가 이깁니다. 이 비교에서 B와 D는 A보다 가까워질 수 없으므로 실제 목록의 우승자가 바뀌는 경계입니다.
원래 유클리드 거리는 w = 1입니다. 앞의 나눗값 [100, 10]은 모든 제곱 거리에 공통인 1/10,000을 제거하면 w = 100에 해당합니다. 공통 인자는 표시 크기를 바꾸지만 순위는 바꾸지 않습니다. 새 그림은 임의의 두 설정을 전부로 여기지 않고 3 부근의 전환을 보여 줍니다. 작고 타당한 가중치 변화로 추천이 뒤집힌다면 첫 결과를 당연한 답처럼 제시하기보다 여러 후보를 보여 주는 편이 유익할 수 있습니다.
그럴듯해 보이기 전에 추천을 들여다보기
작고 눈에 보이는 예제는 불편한 질문을 던지기 좋은 장소입니다. 어떤 특성을 쓰는가, 단위는 무엇인가, 어떻게 척도를 조정했는가, 단위만 바꾸어도 결과가 달라지는가, 모든 후보가 나쁜 선택이라고 인정할 수 있는가. 최신 모델 이야기에 비하면 덜 화려하지만, 시스템이 실제로 무엇을 하는지는 이런 질문에서 더 잘 드러납니다.
로컬 검사는 두 척도의 선택 결과와 질의점에서 자기 자신까지의 거리가 0임을 확인합니다. 범위는 의도적으로 좁습니다. 척도 변경이 순위를 바꾸는 모습을 보여 줄 뿐, 실제 서비스에 맞는 규칙을 결정하지는 않습니다. 유용한 결과는 A가 이겼다는 사실보다 C가 왜 더 이상 이기지 못하는지 정확히 설명할 수 있다는 점입니다.
더 읽어 보기
scikit-learn: nearest-neighbour methods ↗scikit-learn: preprocessing and feature scaling ↗공식 문서와 함께 읽으면 좋은 자료입니다.