이 비밀번호를 만드는 동안 실제로 독립적인 선택은 몇 번 있었을까?
비밀번호는 복잡해 보여도 단순한 조리법을 따를 수 있다. 계절, 연도, 느낌표는 글자를 늘리지만 뜻밖의 선택을 많이 만들지는 않는다. 반대로 독립적으로 뽑은 단어들은 읽기 쉬우면서도 누구나 자연스럽게 쓰는 문장과 다를 수 있다. 완성된 문자열의 장식보다 선택 과정을 살펴볼 필요가 있다.
문장부호보다 선택의 수를 세자.
가능성의 공간을 센다는 것
열두 자리마다 소문자 스물여섯 개 중 하나를 독립적으로 같은 확률로 고른다고 하자. 첫 자리도 스물여섯 가지, 다음 자리도 스물여섯 가지이므로 전체는 26의 12제곱이다. 이는 생성 방식의 수학적 모형이지 누군가의 기존 비밀번호를 평가한 결과가 아니다.
실제로 좋아하는 열두 글자 단어를 골랐다면 알파벳 계산은 선택 과정을 설명하지 못한다. 사람의 취향은 익숙한 패턴에 확률을 집중시킨다. 예상 가능한 접미사를 붙여도 이 성질은 사라지지 않는다. 길이 측정은 정확해도 글자가 어디서 나왔는지는 놓칠 수 있다.
무작위 글자 네 개의 차이
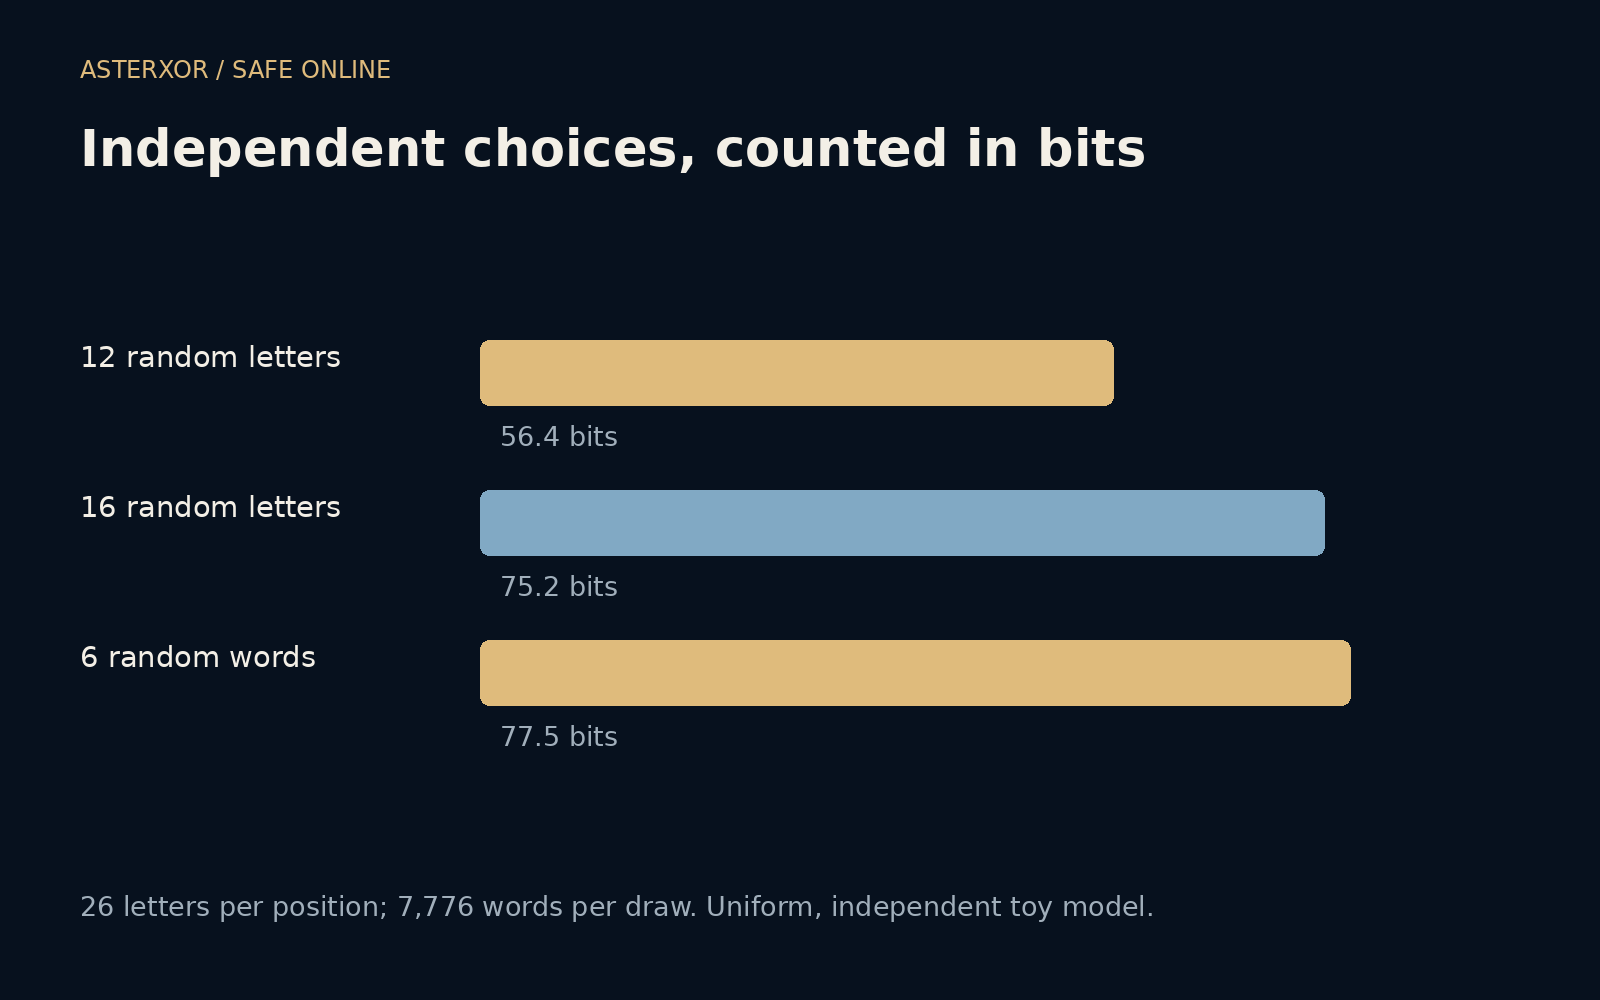
오프라인에서 무작위 소문자 열두 개, 열여섯 개, 그리고 7,776개 단어 목록에서 독립적으로 같은 확률로 고른 여섯 단어를 비교했다. 선택의 양은 각각 약 56.4, 75.2, 77.5비트다. 여기서 비트는 가능한 문자열 수에 밑이 2인 로그를 취한 값이다.
글자 네 개를 더하면 첫 공간은 정확히 456,976배가 된다. 이것은 해독 시간 예측이 아니다. 추측 속도는 서비스의 제한, 비밀번호 저장 방식, 하드웨어, 이미 알려진 정보에 따라 달라진다. 추측 프로그램이나 유출 자료를 사용하지 않았고 실제 계정도 시험하지 않았다.
긴 인용문이 무작위가 되지는 않는다
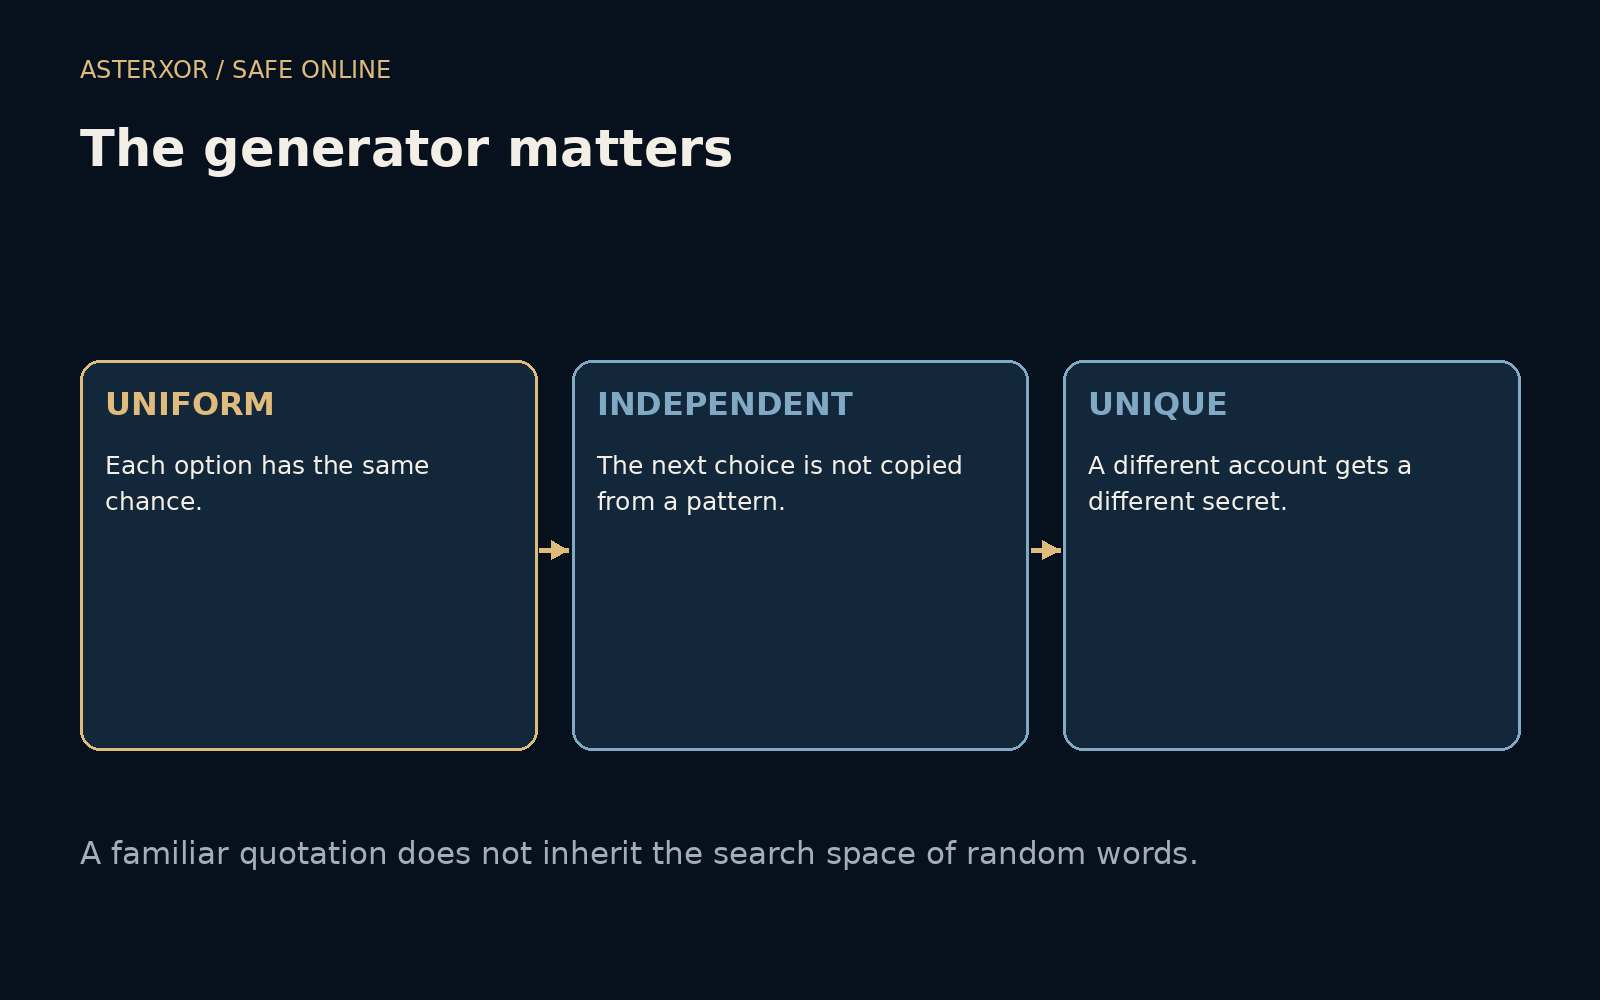
영화에서 기억한 여섯 단어는 독립적으로 뽑은 여섯 단어와 선택 과정이 다르다. 그 순서를 이미 많은 사람이 알 수도 있다. 개인 정보, 흔한 문자 치환, 반복도 비슷한 문제를 만든다. 계산은 긴 문장마다 큰 숫자를 부여하기보다 가정을 드러낼 때 유용하다.
비밀번호 관리자는 계정마다 기억할 이야기를 만들지 않아도 고유한 비밀번호를 생성하고 보관할 수 있다. 꼭 외워야 하는 경우에는 신뢰할 만한 무작위 단어 선택 방법을 고려할 수 있다. 결과를 비공개로 보관하고 기사의 예시를 재사용하지 말자. 이 글에는 복사할 비밀번호를 넣지 않았다.
재사용하지 않는 것은 다른 문제를 해결한다
강한 무작위 비밀번호도 여러 서비스에서 쓰면 중요한 보호를 잃는다. 한 서비스에서 노출되면 정확한 문자열을 이미 아는 사람에게 예측 불가능성은 도움이 되지 않는다. 고유한 비밀번호는 이런 연쇄 노출을 줄이지만 공통 복구 이메일이나 로그인 세션으로 생긴 의존성까지 없애지는 않는다.
비밀번호 관리자와 주요 복구 이메일을 우선 보호하자. 더 강한 로그인 보호를 사용하고 복구 수단을 유지하며 평소 기기를 잃었을 때를 준비한다. 접근을 복구할 수 없거나 진짜 로그인 화면을 구별하지 못한다면 이론적으로 좋은 문자열만으로는 충분하지 않다.
숫자와 가정을 함께 읽자
단어 모형은 독립적인 추출이므로 같은 단어가 반복될 수 있다. 반복을 금지하면 계산이 조금 바뀌고, 듣기 좋은 리듬을 만들려고 단어를 고르면 훨씬 크게 달라진다. 서비스마다 공백과 길이, 문자 지원도 다르다. 지원 범위를 따르되 복잡한 조합 규칙을 좋은 선택 과정의 대체물로 여기지 말자.
오늘 한 가지를 개선한다면 재사용 중인 계정 하나부터 실제 서비스에서 고유한 생성 비밀번호로 바꿔 보자. 안전하게 저장하고 복구도 가능한지 확인한다. 매번 로그를 계산할 필요는 없다. 계산의 목적은 예측하기 어려운 과정과 지속 가능한 습관을 연결하는 데 있다.