看起来一样的重音字母,长度可能不同。
é可以用一个预组合码点表示,也可以由普通e加组合尖音符组成。两种序列可能显示相同,Python却分别数出长度1和2。这不是数错了,而是程序使用的单位不总等于读者心中的“一个字符”。
数文字之前,先说清单位。
字节、码点和可见单位
字节是八位的存储单位;Unicode码点是字符编码空间里的编号;扩展字素簇则是标准分段规则对用户感知字符的近似。渲染还会加入字体、塑形和呈现方式。各层相互配合,但计数未必相同。
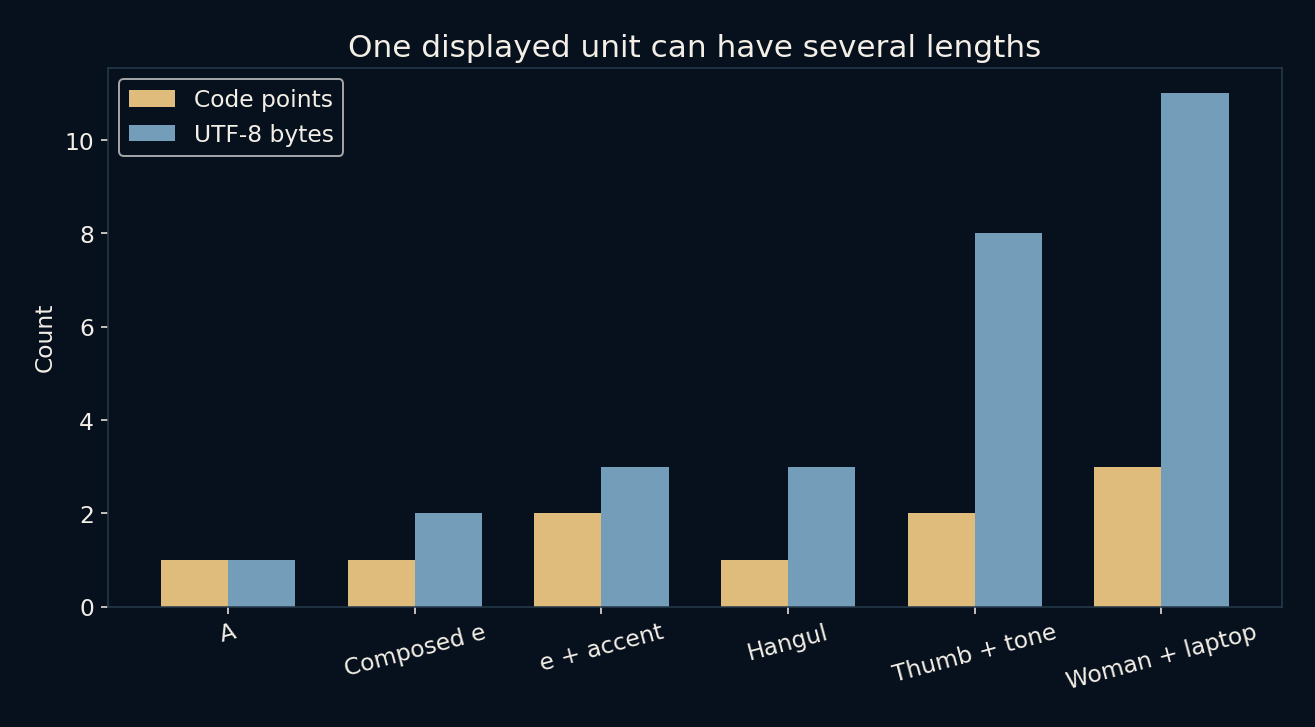
Python字符串是码点序列,因此len计数的是码点。编码成UTF-8后,又能单独计算字节。实验对六个固定例子执行两种计数,没有运行字素分段器,也没测试所有字体是否把每例显示成一个符号。
一个不一定是一字节
A有一个码点和一个UTF-8字节;预组合é有一个码点、两个字节;分解的e加音符有两个码点、三个字节;韩文音节한在本例有一个码点、三个字节。因此,Python字符串长度不能单独决定存储开销。
带肤色的点赞👍🏽有两个码点、八个字节;女程序员👩💻有三个码点、十一个字节,其中包含零宽连接符。支持该序列的渲染器可能把它们合成一个视觉符号。没有单独印出来的部件,也有实际意义。
两种写法可以归到同一形式
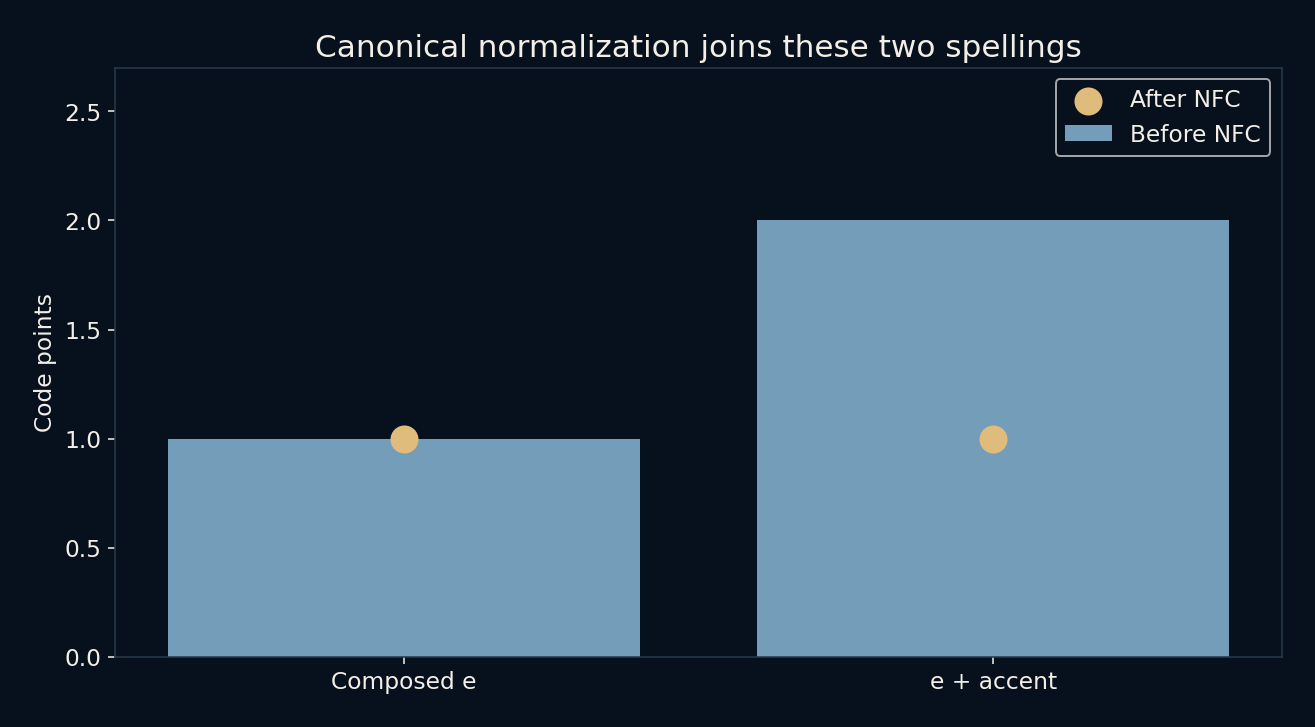
规范化前,两种é在Python中不相等,因为码点序列不同。应用NFC后,本例两者变成相同的预组合形式。脚本确实验证了这个结果,而不是把外观相似直接当作逐字节相同。
规范化不等于随意抹平所有区别。NFC处理规范等价;兼容规范化还会做额外改变,后果不同,两者都不是通用的形似名字检测器。系统应选择适合目的的明确策略,原始形式重要时还要保留输入。
切开存储,也可能切碎视觉符号
字节上限、码点上限和显示字符上限可能停在不同位置。在多字节UTF-8序列中间截断,会留下无效字节;在e与音符之间或表情序列内部切开,码点仍可能有效,却破坏读者预期的符号。
因此截断、光标移动和字数限制需要明确规则。Unicode字素边界提供共同基础,语言和产品情境有时还需补充处理。这六个例子解释为什么需要这一层,不是完整分段测试,也不保证所有编辑器表现一致。
长度限制也是接口承诺
若表单说最多二十个字符,数据库却只许二十个字节,纯ASCII输入可能掩盖矛盾,重音字母和表情则很快暴露它。用户遵守界面规则,仍可能被存储层拒绝。问题是约定不一致,而非文字特别难伺候。
清楚的系统会指定单位,明确编码解码,并测试有代表性的文字和组合,不只测试英文字母。搜索与比较也要谨慎处理相似外观。第一步很简单:把“字符串多长”改问成字节、码点,或人预期怎样编辑的单位有多少。