같아 보이는 악센트 글자도 길이가 다를 수 있다.
é는 미리 조합된 코드 포인트 하나로도, e 뒤에 결합 악센트를 붙여서도 표현한다. 비슷하게 표시되지만 Python은 각각 길이 1과 2로 센다. 셈이 틀린 것이 아니라 프로그램의 단위가 독자의 한 글자와 항상 같지 않은 것이다.
텍스트를 세기 전에 단위를 말하자.
바이트, 코드 포인트, 보이는 단위
바이트는 8비트의 저장 단위다. 유니코드 코드 포인트는 문자 체계의 번호이며 확장 자소 군집은 사용자 인식 문자를 근사하는 표준 분할 단위다. 렌더링에는 글꼴, 글자 모양 처리, 표시 방식도 더해진다. 서로 협력하지만 수는 같지 않을 수 있다.
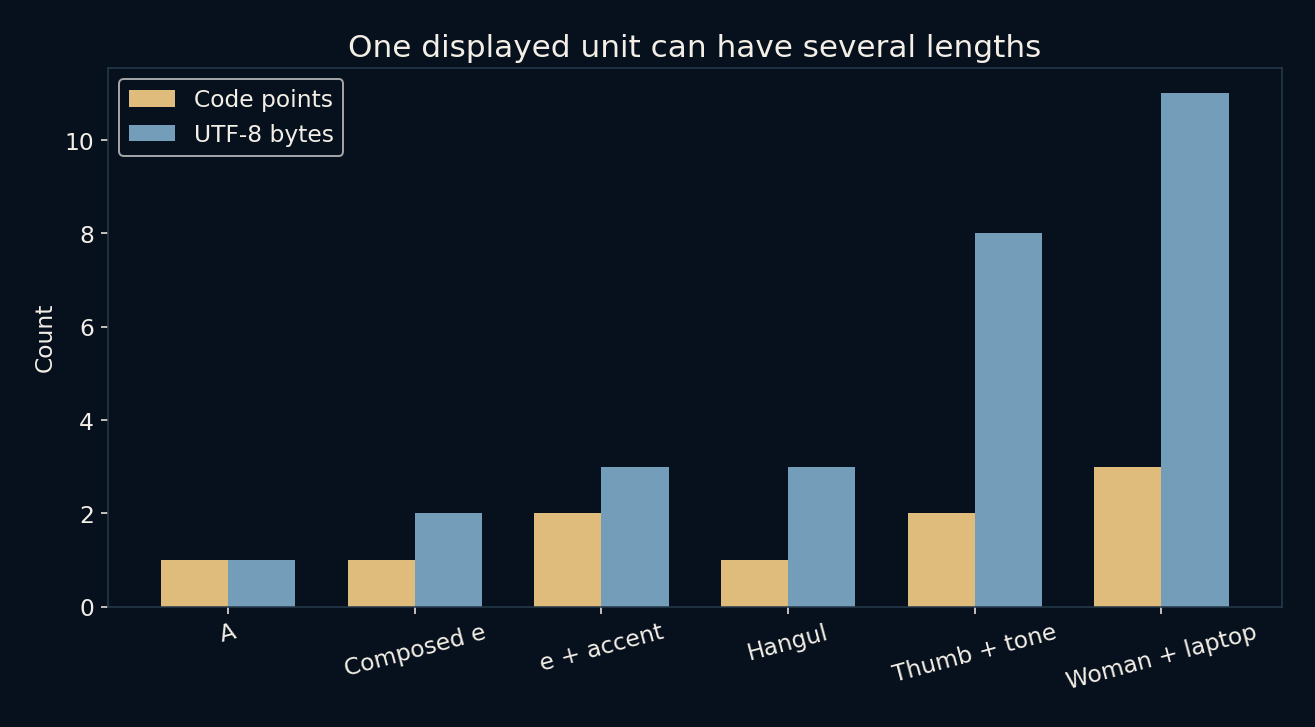
Python 문자열은 코드 포인트의 수열이므로 len은 그 개수를 센다. UTF-8로 인코딩하면 바이트 수를 따로 셀 수 있다. 실험은 고정 예 여섯 개에 두 연산을 수행했다. 자소 분할 엔진이나 모든 글꼴의 단일 기호 표시 여부는 테스트하지 않았다.
하나가 꼭 한 바이트는 아니다
A는 코드 포인트 하나와 UTF-8 한 바이트다. 조합된 é는 코드 포인트 하나지만 두 바이트이고, 분해한 e와 악센트는 두 코드 포인트와 세 바이트다. 한글 음절 한은 이 예에서 한 코드 포인트와 세 바이트다. 문자열 길이만으로 저장량을 알 수 없다.
피부색을 넣은 👍🏽는 코드 포인트 두 개와 여덟 바이트다. 👩💻는 폭 없는 연결자를 포함해 세 코드 포인트와 열한 바이트다. 지원하는 렌더러는 이 요소들을 시각적으로 합칠 수 있다. 별도 인쇄 문자로 보이지 않는 구성 요소도 의미가 있다.
두 표기가 같은 형태에서 만나기
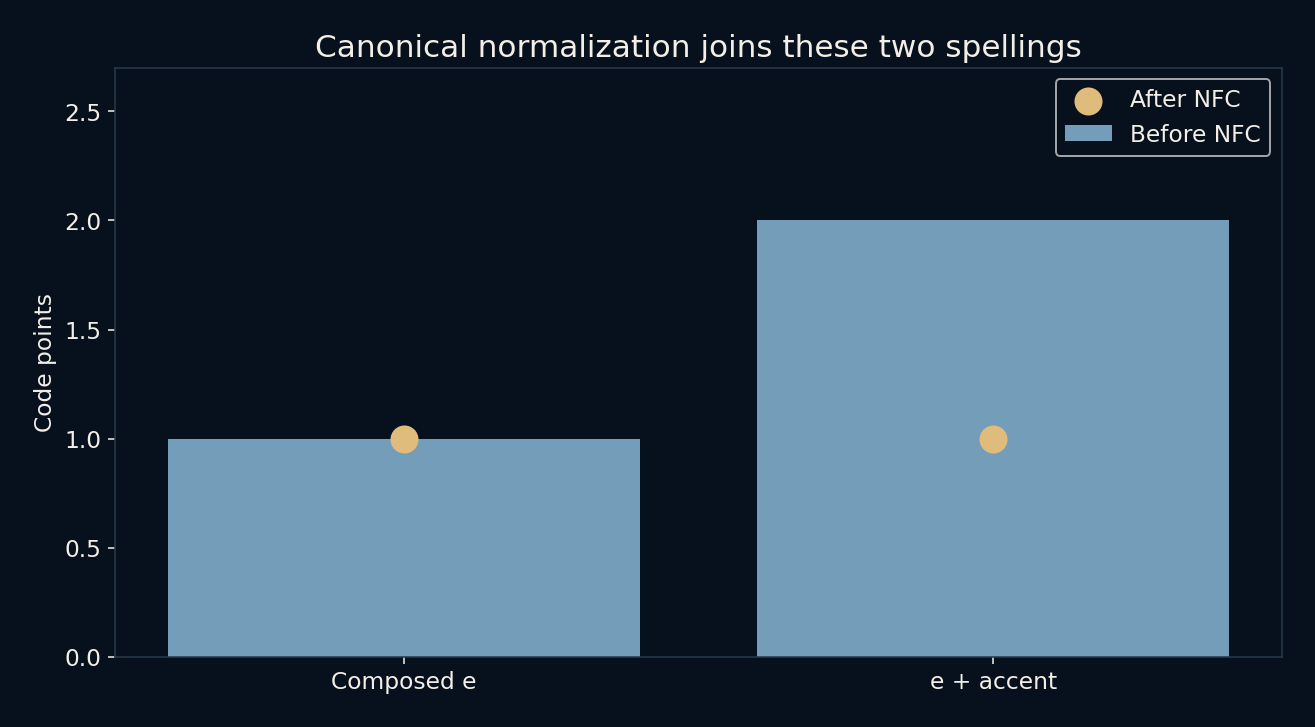
정규화 전 두 é는 코드 포인트 수열이 달라 Python 문자열로 같지 않다. NFC 정규화를 적용하면 이 예에서는 같은 조합형이 된다. 시각적 유사성을 바이트 동일성으로 가정하지 않고 스크립트로 확인했다.
정규화가 모든 차이를 지우라는 뜻은 아니다. NFC는 정준 동등성을 다룬다. 호환 정규화는 추가 변화를 만들며 결과도 다르고, 둘 다 닮은 이름을 찾아내는 만능 방법이 아니다. 목적에 맞는 정책을 문서화하고 원래 형태가 중요하면 입력도 보존해야 한다.
자르면 보이는 한 덩어리가 갈라질 수 있다
바이트 제한, 코드 포인트 제한, 표시 문자 제한은 서로 다른 곳에서 끝날 수 있다. UTF-8 다중 바이트 수열의 중간을 자르면 무효 바이트가 남는다. e와 악센트 사이나 이모지 안을 자르면 유효한 코드 포인트지만 의도한 기호를 깨뜨릴 수 있다.
따라서 잘라내기, 커서 이동, 글자 제한에는 명확한 규칙이 필요하다. 유니코드 자소 경계는 공통 기반이며 언어나 제품 맥락에 따라 추가 처리가 필요할 수 있다. 여섯 예는 그 층이 필요한 이유를 보여 줄 뿐 완전한 분할 검증이나 모든 편집기의 행동 보장은 아니다.
길이 제한은 인터페이스의 약속
입력창은 스무 글자를 허용하지만 저장 필드는 스무 바이트만 허용한다고 하자. ASCII만 쓰면 모순이 숨고 악센트나 이모지를 쓰면 드러난다. 사용자가 화면 규칙을 지켜도 저장이 거절될 수 있다. 까다로운 글 때문이 아니라 계약이 어긋난 것이다.
명확한 시스템은 단위를 지정하고 인코딩과 디코딩을 의도적으로 수행하며 영어뿐 아니라 대표 문자 체계와 조합을 시험한다. 검색과 비교에서도 비슷한 외관을 주의해서 다뤄야 한다. 첫걸음은 길이라는 막연한 질문을 바이트, 코드 포인트, 사람이 기대하는 편집 단위의 질문으로 바꾸는 것이다.
더 읽어 보기
Unicode UAX #29: text segmentation ↗Unicode UAX #15: normalization forms ↗Python: Unicode database operations ↗공식 문서와 함께 읽으면 좋은 자료입니다.